Techniques avancées de modélisation de données pour une analytique d'entreprise évolutive en 2026
La modélisation avancée des données est le socle d'une analytique d'entreprise évolutive. Ce guide explore la conception en schéma en étoile, la modélisation sémantique, l'optimisation des performances, la gestion des relations et les bonnes pratiques de gouvernance pour bâtir des solutions Power BI et Microsoft Fabric performantes, maintenables et prêtes pour l'IA.
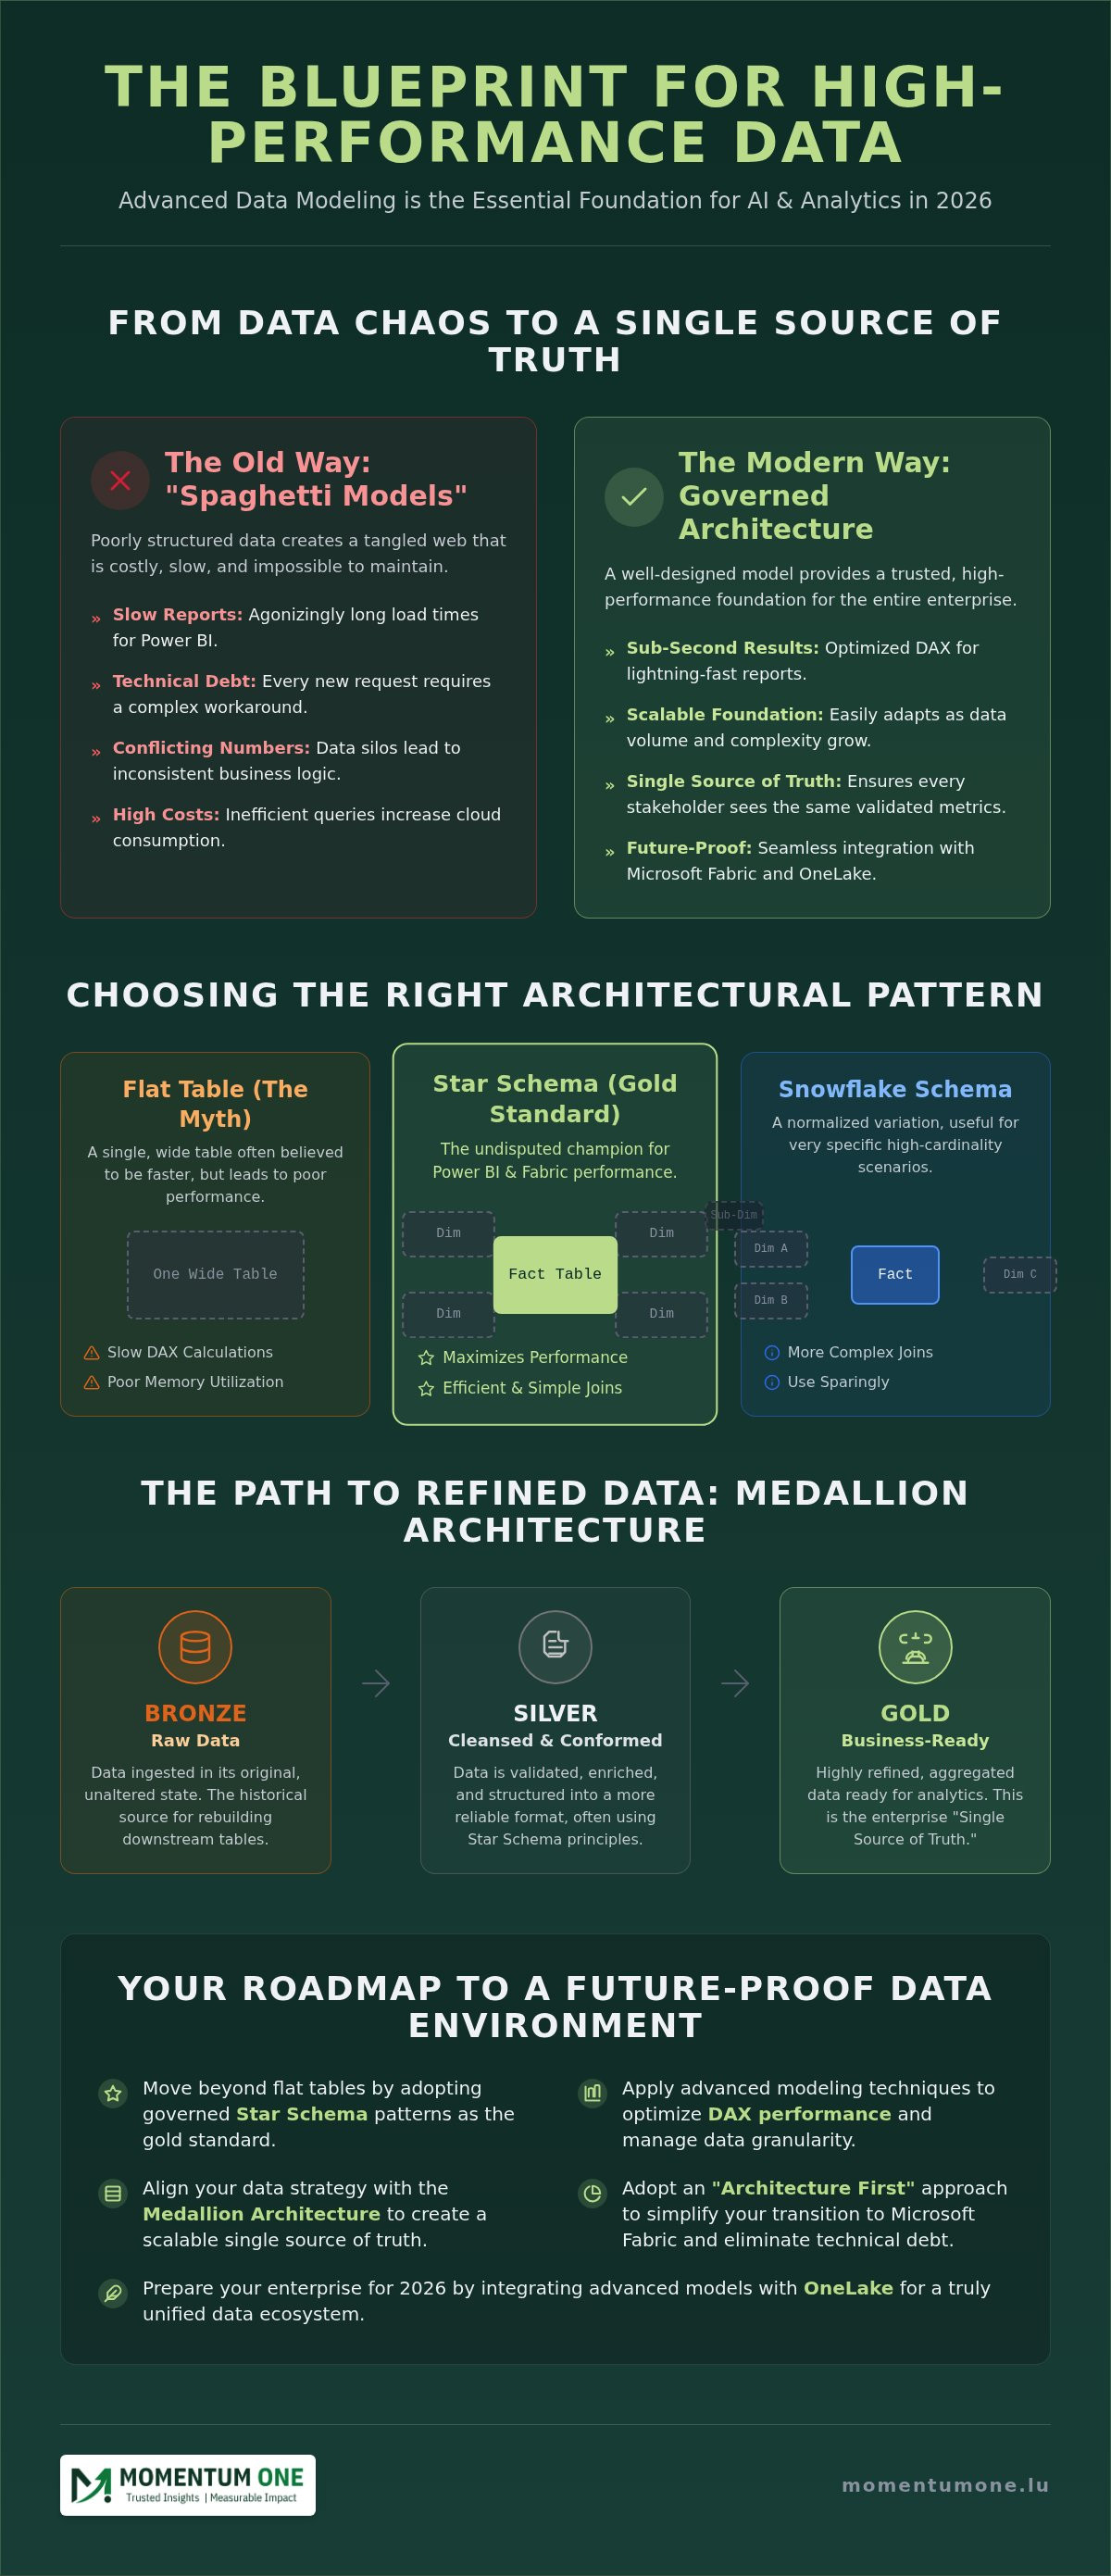
- Dépassez les tables à plat en adoptant des schémas en étoile gouvernés, référence absolue des performances Power BI et Fabric.
- Alignez votre stratégie data sur l'architecture en médaillon, pour transformer des données brutes en une source unique de vérité affinée et évolutive.
- Appliquez des techniques de modélisation avancées pour optimiser votre DAX et maîtriser la granularité, afin que vos rapports restent rapides malgré la croissance.
- Adoptez une approche « l'architecture d'abord » pour simplifier votre passage à Microsoft Fabric tout en supprimant une dette technique coûteuse.
- Préparez votre entreprise au paysage de 2026 en associant des motifs de modélisation avancés à OneLake, pour un environnement de données réellement pérenne.
D'ici 2026, un modèle de données mal structuré ne sera plus un simple désagrément technique : ce sera un frein direct à chaque projet d'IA et d'analytique en temps réel de votre entreprise. Vous avez sans doute éprouvé l'agacement d'un rapport Power BI interminable à charger, ou le casse-tête de chiffres contradictoires d'une direction à l'autre. Mettre en œuvre des techniques de modélisation avancées n'est plus optionnel si vous voulez conserver votre avance. C'est le socle indispensable à des données exactes, accessibles et prêtes pour la prochaine génération de décisionnel performant.
Nous savons que migrer des modèles hérités vers Microsoft Fabric ou gérer des relations complexes entre plusieurs tables de faits peut sembler intimidant. Cet article trace un chemin clair pour bâtir une source unique de vérité évolutive, tout en réduisant fortement votre dette technique. Vous apprendrez à maîtriser les stratégies architecturales des environnements pérennes et à optimiser vos performances DAX pour des réponses en moins d'une seconde. Nous parcourrons les motifs de modélisation qui garantissent une intégration fluide à OneLake et une réussite dans un écosystème lakehouse moderne.
Un actif stratégique
La décision stratégique dans l'entreprise moderne ne repose pas seulement sur de l'information brute : elle exige un plan structuré, capable de traduire des données complexes en analyses exploitables. En maîtrisant les techniques de modélisation avancées, les organisations dépassent les limites des tables à plat et des tableurs cloisonnés. Cette évolution est essentielle pour quitter des modèles « rapides » en libre-service, souvent incohérents, au profit d'une architecture d'entreprise gouvernée, qui grandit avec l'activité. Un modèle bien conçu renforce la culture data dans tous les services, parce que les utilisateurs se fient enfin aux chiffres qu'ils voient. Il ne s'agit pas seulement d'organisation, mais de performance : un modèle solide pèse directement sur vos coûts de consommation cloud, en réduisant la puissance de calcul nécessaire au traitement de requêtes complexes dans des environnements comme Microsoft Fabric.
Le travail de modélisation des données fait le pont entre le stockage technique et l'utilité métier. Il garantit que la logique de calcul d'une « marge bénéficiaire » à la finance correspond à celle employée aux ventes. Sans cet alignement, l'adoption s'enraye et l'investissement dans des plateformes coûteuses ne produit pas les résultats attendus. Nous voyons la modélisation comme l'appui stable qui guide une entreprise à travers le bruit des données massives, vers la clarté et la croissance.
Le coût élevé d'une architecture médiocre
Des « modèles spaghetti » mal pensés créent un enchevêtrement de dépendances presque impossible à entretenir. Ces structures inefficaces engendrent une lourde dette technique, où chaque nouveau rapport exige un contournement plutôt qu'une procédure standard. Cette complexité produit une latence visible, qui agace les utilisateurs et les ramène aux exports Excel manuels. Ces silos empêchent toute vision d'ensemble de l'entreprise et engendrent des logiques métier incohérentes. En 2026, une source unique de vérité est une couche sémantique unifiée et gouvernée, qui garantit à chaque partie prenante les mêmes indicateurs validés, quel que soit son point d'entrée.
Modélisation ou ingénierie des données : où passe la frontière ?
Il est essentiel de savoir où s'arrête l'ingénierie des données et où commence la modélisation sémantique. L'ingénierie s'occupe de la « plomberie » : les traitements ETL et ELT qui déplacent et transforment la donnée pour la rendre exploitable. La modélisation sémantique donne à cette donnée son sens métier. C'est le domaine de l'analytics engineer, ce profil qui relie les pipelines bruts au rapport final. Il veille à ce que les techniques de modélisation avancées produisent une couche performante pour les utilisateurs. Pour les organisations qui veulent aligner exécution technique et objectifs de long terme, nos services de conseil et gouvernance Power BI apportent le cadre stratégique nécessaire à la gestion de cette frontière. Nous vous aidons à définir des rôles et des standards clairs, qui préviennent la dérive architecturale et gardent votre architecture sobre et réactive.
Motifs d'architecture : schéma en étoile, en flocon et environnements multi-faits
Le schéma en étoile reste la référence incontestée des performances de Power BI et Microsoft Fabric. Certains estiment que la puissance de calcul actuelle rend la conception de schéma indifférente ; en réalité, le moteur VertiPaq et le mode Direct Lake s'épanouissent sur des structures dimensionnelles claires. Un schéma en étoile limite la complexité des jointures et maximise l'efficacité de la compression en colonnes. Nous rencontrons souvent le mythe de la « table à plat » : l'idée qu'une unique table très large serait plus rapide parce qu'elle évite les jointures. En pratique, ces tables larges entraînent une mauvaise utilisation de la mémoire et des calculs DAX plus lents, car elles obligent le moteur à parcourir plus de données que nécessaire. En vous appuyant sur des techniques de modélisation avancées, vous gardez une architecture sobre et réactive, même lorsque vos volumes atteignent le pétaoctet.
Dans certains cas, un schéma en flocon, qui normalise les tables de dimensions, reste acceptable, voire nécessaire : lorsque vous traitez des dimensions à très forte cardinalité ou que des exigences héritées imposent une normalisation stricte. Pour la plupart des scénarios d'entreprise, nous visons toutefois la simplicité de l'étoile. Lorsque votre logique métier couvre plusieurs processus — ventes, stocks, expéditions —, vous mettrez sans doute en place un « schéma en galaxie », qui relie plusieurs tables de faits par des dimensions partagées, dites conformées. Comprendre ces approches modernes de modélisation vous permet de bâtir un environnement cohérent, où différentes unités métier produisent leurs rapports dans un cadre unifié, sans créer de silos redondants.
Maîtriser la modélisation dimensionnelle
Maîtriser le rôle des tables de faits et de dimensions est déterminant à grande échelle. Les tables de faits portent les mesures quantitatives, les dimensions apportent le contexte. Gérer leur évolution dans le temps compte tout autant : nous employons les dimensions à variation lente (SCD) pour suivre l'historique — le type 1 écrase simplement la donnée, le type 2 conserve l'historique complet des changements. Dans des modèles natifs du cloud, nous recommandons vivement l'usage de clés de substitution plutôt que de clés naturelles : cela découple votre modèle analytique de la volatilité des systèmes sources et offre un socle stable à votre conception d'entrepôt de données et de lakehouse.
Résoudre des relations complexes
Traiter des relations plusieurs-à-plusieurs demande de la finesse, sous peine de goulets de performance. Power BI les prend en charge nativement, mais elles peuvent créer des ambiguïtés si elles sont mal gérées. Nous déconseillons généralement le filtrage bidirectionnel, source de résultats inattendus et de dépendances circulaires. Employez plutôt des dimensions à rôles multiples pour gérer plusieurs relations entre les mêmes tables, comme « date de commande » et « date d'expédition » dans une même table de faits. Si votre architecture devient difficile à administrer, notre équipe peut appliquer des techniques de modélisation avancées pour simplifier vos relations et restaurer des rapports en moins d'une seconde.
Modéliser pour le lakehouse moderne : Microsoft Fabric et OneLake
Le passage d'entrepôts SQL traditionnels à des lakehouses Microsoft Fabric marque un changement de fond dans la façon de stocker et de consommer l'information. Les principes de la modélisation dimensionnelle restent valables, mais leur mise en œuvre physique a évolué pour privilégier souplesse et rapidité. Dans ce nouvel environnement, les techniques de modélisation avancées visent à optimiser la circulation de la donnée dans l'architecture en médaillon. Ce cadre organise l'information en trois couches : bronze, argent et or. La couche bronze sert de zone d'atterrissage pour les données brutes, dans leur format d'origine. La couche argent est celle du nettoyage et de la première modélisation ; la couche or constitue la couche affinée, prête pour le métier, où les schémas en étoile prennent tout leur sens.
Au cœur de cette modernisation, l'usage de fichiers Delta Parquet comme socle universel de stockage. Ce format ouvert permet à différents moteurs de calcul d'accéder aux mêmes données, sans verrou propriétaire. En normalisant sur Delta Parquet dans OneLake, vous supprimez les copies redondantes et simplifiez votre architecture. Pour les organisations qui abordent cette transition, nos services de migration et modernisation Fabric fournissent la trajectoire technique nécessaire pour transférer vos systèmes hérités dans cet écosystème performant, sans perturber vos opérations.
Le mode Direct Lake : le changement de paradigme de 2026
Le mode Direct Lake est l'avancée qui définit le paysage analytique de 2026. Il permet à Power BI de lire les fichiers Delta Parquet directement dans OneLake, sans actualisation traditionnelle ni latence du DirectQuery. Pour rester en Direct Lake, vous devez respecter certaines contraintes de modélisation : types de données compatibles, relations clairement définies. Contrairement au mode Import, qui exige des actualisations gourmandes en mémoire, ou au DirectQuery, souvent pénalisé par des temps de réponse longs, Direct Lake offre la performance d'un modèle en mémoire et la fraîcheur d'une connexion en direct. C'est le choix idéal pour d'immenses jeux de données d'entreprise, où la réponse en moins d'une seconde ne se négocie pas.
La couche or : concevoir la couche sémantique
Concevoir la couche or, c'est offrir une expérience fluide aux utilisateurs en libre-service. Cette couche doit être la référence définitive de tous vos indicateurs métier, structurée pour une exploration intuitive. Nous recourons aux raccourcis OneLake pour relier des données de sources variées sans les déplacer, ce qui réduit fortement duplication et coûts de stockage. Votre couche sémantique reste ainsi sobre tout en offrant une vue complète de l'organisation. Si vous hésitez encore entre différentes voies architecturales, notre guide sur la conception lakehouse ou entrepôt de données approfondit le choix de la structure adaptée à vos besoins. En appliquant des techniques de modélisation avancées à ce dernier stade, vous transformez des données brutes en actif stratégique, qui permet à chaque service de décider plus vite et plus juste.
Optimisation avancée : DAX, granularité et réglage des performances
Le réglage des performances est le moment où un modèle théorique rencontre la réalité de l'échelle. Dans un environnement à fort volume, les techniques de modélisation avancées doivent placer l'efficacité du moteur VertiPaq au premier plan. L'une des stratégies les plus efficaces consiste à remonter la logique métier le plus en amont possible. Le DAX est puissant, mais réaliser des transformations complexes pendant le chargement — en SQL ou via des pipelines Fabric — est nettement plus efficace que d'utiliser des colonnes calculées. Cette approche allège le traitement au moment de la requête et garde votre environnement vif pour les utilisateurs.
Le secret d'un modèle sobre tient à la maîtrise de la cardinalité des colonnes. Une forte cardinalité, c'est-à-dire un grand nombre de valeurs distinctes, est le premier ennemi de la compression. En supprimant les colonnes trop fines et inutiles — horodatages, identifiants uniques non employés dans des relations —, vous réduisez fortement l'empreinte mémoire de votre modèle. Piloter ces détails techniques est essentiel à un écosystème sain. Pour les organisations qui ont besoin d'aide sur le réglage de leur infrastructure, nos services de gestion des espaces de travail et des capacités alignent parfaitement vos ressources sur les exigences de votre modèle.
L'optimisation DAX sur de grands volumes
Écrire un DAX efficace est déterminant quand vos tables atteignent des millions, voire des milliards de lignes. Évitez les itérateurs coûteux comme SUMX ou FILTER sur de grandes tables chaque fois qu'un agrégateur plus simple suffit. Nous employons également des groupes de calcul pour alléger les modèles complexes : cette technique permet d'appliquer une même logique, comme une croissance d'une année sur l'autre, à plusieurs mesures sans multiplier les mesures. Comprendre les mécanismes de base reste essentiel : le contexte de ligne parcourt une table ligne par ligne, tandis que le contexte de filtre définit l'ensemble de données que le calcul observe, selon les segments et filtres du rapport. Si vos rapports traînent, nos experts proposent une modélisation et une optimisation DAX spécialisées pour restaurer les performances.
Granularité et stratégies d'agrégation
Concilier besoin de détail et exigence de rapidité est un défi permanent. Nous y répondons par des agrégations définies par l'utilisateur (UDA) : Power BI interroge une petite table pré-agrégée pour les visuels de synthèse et « descend » vers le détail uniquement lorsque c'est nécessaire. Cette approche structurelle garde vos rapports rapides sans sacrifier la profondeur d'analyse. Pour approfondir le maintien de la qualité des données tout au long de ce travail, consultez notre guide sur l' amélioration de l'exactitude des rapports. En appliquant ces techniques de modélisation avancées, vous bâtissez un système à la fois complet et remarquablement rapide.
Mettre en place un cadre évolutif avec Momentum One
Bâtir un environnement de données évolutif demande plus que des connaissances techniques : il faut un partenaire stratégique, conscient des conséquences durables de chaque choix d'architecture. Nous sommes cet appui stable, qui accompagne les entreprises dans des migrations complexes avec un souci constant de stabilité et de performance. Notre approche « l'architecture d'abord » garantit que les techniques de modélisation avancées ne sont pas appliquées comme un pansement, mais tissées dans la trame même de votre mise en œuvre. Cette méthode évite l'accumulation de dette technique et crée un socle résilient, qui soutient votre croissance sur la durée. Nous sommes convaincus qu'un modèle ne vaut que par la stratégie qui le porte : c'est pourquoi nous plaçons l'intégrité structurelle au premier plan dès le premier jour.
Les services managés jouent ici un rôle déterminant. Il ne suffit pas de bâtir un modèle performant : il faut en préserver l'intégrité à mesure que vos besoins et vos volumes évoluent. Nous assurons la supervision continue nécessaire pour que votre couche sémantique reste la source unique de vérité de toute l'organisation. En associant ce soutien managé à des formations spécialisées, nous vous aidons à développer une excellence interne en modélisation. Cette double approche permet à vos équipes de produire leurs analyses quotidiennes tout en gardant une architecture optimisée pour les dernières capacités de Microsoft Fabric et les exigences de Direct Lake.
Des silos hérités à une architecture Fabric moderne
Moderniser des environnements Power BI ou SQL hérités revient souvent à démêler un écheveau de logiques dépassées et de silos poussifs. Nous traçons une trajectoire claire pour cette transition et repérons la dette technique avant qu'elle ne devienne un goulet dans votre nouvel environnement. Notre équipe transforme ces systèmes fragmentés en une architecture unifiée et gouvernée. Pour les équipes qui souhaitent maîtriser ces évolutions en interne, nos formations data fabric en entreprise offrent l'expertise pratique nécessaire à une montée en compétence rapide. Nous ne migrons pas seulement vos données : nous modernisons toute votre approche analytique, avec des techniques de modélisation avancées éprouvées à grande échelle.
Votre partenaire d'une stratégie data performante
Choisir un Microsoft Solutions Partner certifié est déterminant pour réussir dans le paysage de 2026. Fort de plus de 8 ans d'expérience dans des environnements de données complexes, nous apportons une précision et une fiabilité que des prestataires généralistes ne peuvent égaler. Nous sommes prêts à mener avec vous une revue architecturale complète, pour repérer les écarts de performance et les occasions d'évolution. Votre prochaine étape consiste à quitter le dépannage réactif pour une stratégie data anticipée. Travaillons ensemble à bâtir un environnement performant, à la hauteur de la fiabilité et de la clarté que votre entreprise mérite.
Préparez votre stratégie data pour 2026 et au-delà
Maîtriser les techniques de modélisation avancées ne relève pas du seul souci de propreté technique : il s'agit de bâtir un moteur fiable de croissance. En adoptant un schéma en étoile gouverné et l'architecture en médaillon dans Microsoft Fabric, vous créez une source unique de vérité évolutive. Ces choix structurels, associés à une optimisation DAX précise, gardent votre environnement analytique rapide et réactif malgré la croissance de vos volumes. Vous n'avez pas à vous contenter de rapports lents ni de logiques incohérentes quand une meilleure architecture est à portée de main.
Microsoft Solutions Partner certifié spécialisé en migration Fabric et en réglage des performances, Momentum One se consacre à votre réussite. Nous proposons des formations animées par des experts et un conseil de haut niveau, pour aider vos équipes à supprimer la dette technique et à adopter des standards d'architecture modernes. Travaillons ensemble à bâtir un environnement qui apporte clarté et fiabilité à chaque unité métier. Réservez une revue architecturale avec Momentum One pour engager votre transformation. Un environnement de données performant est à votre portée, et nous sommes là pour vous accompagner à chaque étape.
Questions Fréquemment Posées
Quelle différence entre schéma en étoile et schéma en flocon dans Power BI ?
Un schéma en étoile comporte une table de faits centrale, reliée directement à des tables de dimensions à un seul niveau : une structure simple et rapide. Un schéma en flocon normalise ces dimensions en plusieurs tables liées, ce qui complexifie le modèle. Power BI donne le meilleur avec un schéma en étoile, car il réduit le nombre de jointures que le moteur doit traiter, d'où des interactions bien plus rapides.
Pourquoi la modélisation compte-t-elle dans une migration vers Microsoft Fabric ?
La modélisation est le socle architectural qui détermine les performances de vos données dans un environnement lakehouse. Sans structure propre, vous ne pourrez pas tirer pleinement parti de fonctions comme le mode Direct Lake ou l'intégration à OneLake. Appliquer des techniques de modélisation avancées pendant votre migration vous évite de déplacer d'anciens problèmes vers une nouvelle plateforme et vous permet de bâtir un environnement évolutif et pérenne.
Quel effet la granularité a-t-elle sur les performances des rapports Power BI ?
La granularité définit le niveau de détail de vos tables : plus elle est fine, plus vous avez de lignes et souvent de valeurs distinctes. Cette cardinalité accrue complique la compression par le moteur VertiPaq, d'où des rapports poussifs et une forte consommation mémoire. Il faut souvent arbitrer entre le besoin de détail à la transaction et la rapidité de données agrégées, pour garder un environnement réactif.
Peut-on appliquer ces techniques de modélisation à des données Excel ?
Oui : vous pouvez tout à fait appliquer ces principes dans Excel, grâce au modèle de données Power Pivot. Comme Power Pivot s'appuie sur le même moteur tabulaire que Power BI, il profite autant des schémas en étoile et d'une gestion efficace des relations. C'est un excellent moyen d'éviter l'alourdissement de vos classeurs et de garder des tableurs complexes administrables à mesure que vos données grandissent.
Qu'est-ce qu'un groupe de calcul et quand l'utiliser ?
Les groupes de calcul permettent d'appliquer une même logique — croissance d'une année sur l'autre, conversion de devise — à de nombreuses mesures d'un coup. Employez-les dès que vous vous surprenez à créer des dizaines de mesures similaires, qui ne diffèrent que par un calcul d'intelligence temporelle. Cette approche garde votre modèle propre et bien plus facile à maintenir quand vos besoins métier évoluent.
En quoi le mode Direct Lake change-t-il la modélisation en 2026 ?
Le mode Direct Lake supprime l'exigence traditionnelle d'actualisation ou d'import, en lisant les fichiers Delta Parquet directement dans OneLake. En 2026, cela suppose une modélisation très précise, pour que le moteur parcoure les fichiers efficacement sans retomber dans des modes de requête plus lents. Les types de données normalisés et des relations propres deviennent prioritaires pour tenir les performances infra-secondes attendues.
Qu'est-ce que l'architecture en médaillon dans un lakehouse ?
L'architecture en médaillon est un motif de conception qui organise la donnée en trois couches : bronze pour les données brutes, argent pour les données nettoyées et modélisées, or pour les analyses prêtes pour le métier. Cette structure garantit qu'à son arrivée en couche or, la donnée est pleinement optimisée pour le reporting et le libre-service. Elle offre une trajectoire claire de qualité et aide les équipes à piloter des pipelines complexes avec bien plus d'assurance.
Comment optimiser le DAX sur de très grands jeux de données ?
Optimiser le DAX sur d'immenses tables commence par éviter les itérateurs coûteux comme SUMX ou FILTER appliqués à toute la table, et par travailler le contexte de filtre. Vous obtiendrez également de meilleurs résultats en remontant la logique complexe vers la couche d'entrepôt plutôt qu'en la calculant à l'exécution. Bien souvent, la meilleure façon de corriger une mesure lente consiste à appliquer des techniques de modélisation avancées, afin de réduire le volume de données que la mesure doit parcourir.