Bonnes pratiques Azure Databricks : les meilleurs conseils de performance
Découvrez les meilleures bonnes pratiques Azure Databricks pour optimiser les performances, réduire les coûts et sécuriser votre Lakehouse. Maîtrisez Unity Catalog et DBR 19
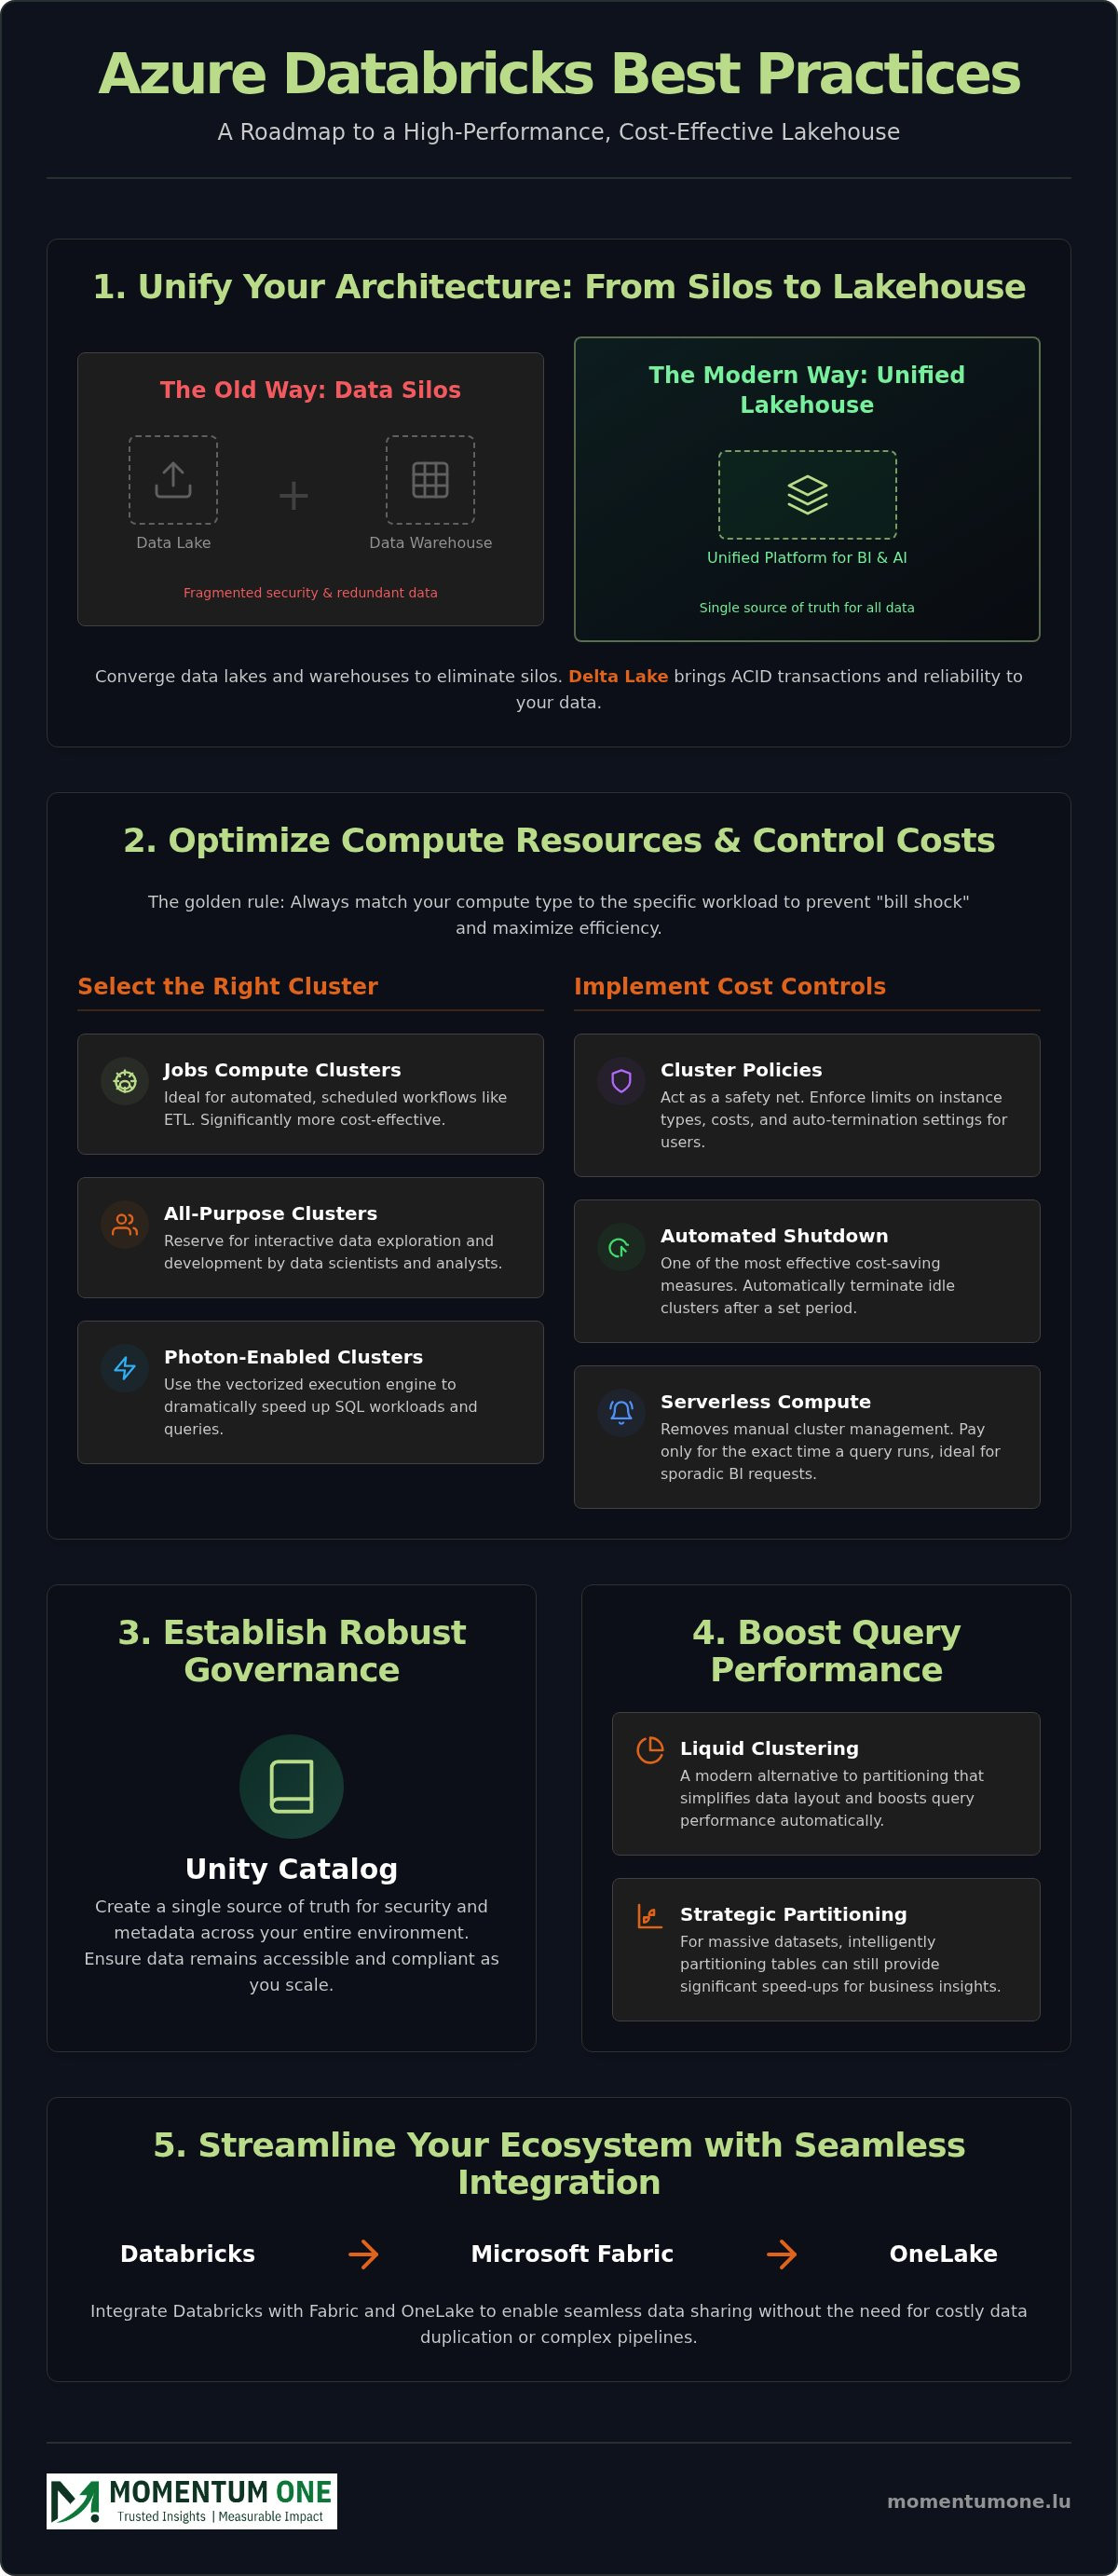
- Alignez votre stratégie data en faisant converger data lakes et entrepôts vers une architecture Lakehouse unifiée, pour supprimer les silos et gagner en intelligence des données.
- Appliquez les bonnes pratiques Azure Databricks côté calcul en adaptant chaque type de ressource à sa charge de travail et en exploitant les options serverless pour alléger la charge opérationnelle.
- Mettez en place un cadre de gouvernance solide avec Unity Catalog pour créer une source unique de vérité en matière de sécurité et de métadonnées, à l'échelle de tout votre environnement.
- Accélérez vos requêtes et gagnez en efficacité de modélisation grâce aux fonctionnalités Delta Lake comme le Liquid Clustering et un partitionnement réfléchi.
- Simplifiez votre écosystème en intégrant Databricks à Microsoft Fabric et OneLake pour partager vos données sans duplication coûteuse.
Et si votre Lakehouse performant était en réalité une fuite discrète dans votre budget d'exploitation ? Beaucoup d'équipes data affrontent le « Far West » d'un accès aux données sans gouvernance et la morsure de dépenses cloud imprévisibles, causées par des clusters mal configurés. Il est fréquent de voir des rapports Power BI en aval ralentir pendant que vos factures Azure grimpent, à cause du double modèle de facturation entre consommation de DBU et coûts d'infrastructure. En appliquant des bonnes pratiques Azure Databricks éprouvées, vous transformez cette complexité en actif métier maîtrisé et faites de votre environnement un socle fiable pour la croissance.
Ce guide trace une feuille de route claire pour maîtriser les stratégies d'architecture, de sécurité et d'optimisation des coûts d'un Lakehouse moderne. Avec le retrait annoncé du niveau standard d'Azure Databricks en octobre 2026, le moment est venu d'affiner votre configuration pour la stabilité de long terme. Nous verrons comment tirer parti du Databricks Runtime 19, automatiser votre environnement pour alléger la charge et utiliser Unity Catalog 0.6.0 pour garder vos données sécurisées. Vous disposerez des clés pour bâtir un écosystème évolutif et sûr, qui raccourcit le délai d'analyse pour chaque utilisateur métier.
Le Lakehouse moderne : pourquoi les bonnes pratiques Azure Databricks comptent en 2026
Le paysage data a évolué rapidement et, en 2026, la distinction entre data lakes à grande échelle et entrepôts de données performants s'est largement effacée. Cette convergence porte le nom d'architecture Lakehouse, et Databricks en est le moteur principal en matière d'intelligence des données unifiée. Un Lakehouse est une plateforme unifiée pour la BI et l'IA. Sans approche structurée, les environnements accumulent toutefois vite une dette architecturale. Elle se manifeste par des jeux de données redondants, des coûts qui s'envolent et des politiques de sécurité fragmentées qui bride l'agilité de vos équipes. Adopter les bonnes pratiques Azure Databricks n'est pas un simple choix technique : c'est une nécessité stratégique pour garder un environnement stable et productif.
Des silos de données à l'intelligence unifiée
Dans bien des configurations traditionnelles, data scientists et analystes métier évoluent dans des mondes séparés, avec des outils différents. Databricks fait tomber ces barrières en offrant un espace de travail partagé où données brutes et analyses affinées coexistent. Au cœur de cette transition se trouve Delta Lake, qui apporte transactions ACID et fiabilité à votre data lake. En 2026, bâtir un environnement performant suppose de placer la gouvernance en premier. Avec le retrait du niveau standard des espaces de travail Azure Databricks prévu en octobre 2026, évoluer vers une architecture premium et gouvernée garantit des données accessibles et conformes à mesure que votre organisation grandit. Chaque utilisateur, quel que soit son niveau technique, travaille alors depuis la même source de données de qualité.
La valeur métier de la rigueur architecturale
Une conception rigoureuse se traduit directement par un ROI plus rapide sur vos projets data. Lorsque votre architecture est optimisée, vos utilisateurs obtiennent des réponses en quelques secondes plutôt qu'en quelques minutes, et le coût total de possession baisse nettement. Une conception proactive évite les factures surprises, souvent liées à des clusters de calcul non pilotés ou à des traitements inefficaces. En travaillant votre conception d'entrepôt de données et de Lakehouse, vous bâtissez un socle stable qui répond à vos besoins de reporting actuels comme à vos futures initiatives d'IA. Cette approche structurée réduit la friction opérationnelle et permet à vos équipes de créer de la valeur plutôt que de réparer des pipelines. Suivre ces bonnes pratiques Azure Databricks fait de votre environnement technique un actif métier performant plutôt qu'un fardeau complexe.
Optimiser les ressources de calcul et maîtriser les coûts
Maîtriser ses coûts cloud demande plus que la surveillance d'un tableau de bord : cela exige une stratégie proactive qui aligne l'infrastructure sur l'intention. La règle d'or des bonnes pratiques Azure Databricks est simple : adaptez toujours le type de calcul à la charge de travail. Utiliser un coûteux cluster interactif pour un traitement ETL en arrière-plan est une négligence courante qui gonfle les factures sans rien apporter. En classant vos tâches entre ETL et BI, vous vous assurez que chaque euro dépensé contribue directement à la performance. Cette approche évite le choc de facture souvent associé au double modèle de facturation entre DBU et infrastructure Azure sous-jacente.
Choisir le bon cluster pour la bonne tâche
Les clusters Jobs Compute sont conçus pour des traitements automatisés et planifiés. Ils sont nettement plus économiques que les clusters All-Purpose, à réserver à l'exploration et au développement interactifs. Pour des requêtes performantes, les clusters activés avec Photon offrent un moteur d'exécution vectorisé qui accélère spectaculairement les charges SQL. Le choix de la famille de machines virtuelles est tout aussi déterminant : privilégiez des instances optimisées pour la mémoire sur les traitements lourds, et optimisées pour le calcul sur les tâches très gourmandes en calcul mais moins en mémoire. Un bon appariement des ressources garde votre environnement réactif sans gaspiller de capacité.
Cadres stratégiques de maîtrise des coûts
Les politiques de cluster jouent le rôle de filet de sécurité : elles empêchent les utilisateurs de lancer par inadvertance des instances surdimensionnées et coûteuses. Elles permettent aux administrateurs d'imposer des limites sur les types d'instances et les paramètres d'arrêt automatique. En 2026, le calcul serverless est devenu un pilier de l'efficacité opérationnelle. Il supprime la gestion manuelle des clusters et fait que vous ne payez que la durée exacte d'exécution d'une requête, ce qui est particulièrement utile pour des demandes décisionnelles ponctuelles. Les déclencheurs d'arrêt automatique restent l'un des moyens les plus efficaces de protéger votre budget des ressources inactives.
Recourir aux instances Spot pour des traitements par lots non critiques peut réduire vos coûts d'infrastructure jusqu'à 70 %. Pour appliquer ces réglages de manière homogène dans toute l'organisation, il est souvent utile de faire appel à une gestion experte des espaces de travail et des capacités. L'étiquetage de vos clusters est une autre étape essentielle pour attribuer finement les coûts. Vos équipes financières peuvent ainsi suivre la dépense par service ou par projet et transformer une facture cloud floue en rapport transparent. Si vous souhaitez maintenir un environnement sobre, nos équipes peuvent déployer ces contrôles avec vous dans le cadre de nos services managés, pour que votre Lakehouse reste un actif performant.
Instaurer une gouvernance solide avec Unity Catalog
La gouvernance des données est souvent perçue comme un arbitrage entre sécurité et rapidité. Unity Catalog change la donne en devenant la source unique de vérité de toutes vos métadonnées et politiques de sécurité. Il simplifie la gestion multi-espaces de travail en centralisant l'administration des utilisateurs, des groupes et des permissions sur l'ensemble de vos environnements Databricks. En adoptant ces bonnes pratiques Azure Databricks, vous protégez vos données sans les rendre inaccessibles à ceux qui en ont le plus besoin. Cette centralisation transforme la gouvernance, de goulet d'étranglement en moteur de confiance.
Centraliser contrôle d'accès et traçabilité
Les modèles de gouvernance traditionnels reposaient souvent sur une sécurité locale à l'espace de travail, source de silos et de règles d'accès incohérentes. Passer à une gouvernance au niveau du compte vous permet de gérer les permissions globalement : un utilisateur dispose des mêmes droits qu'il travaille en développement ou en production. La traçabilité automatique des données est un élément clé de ce dispositif. Elle suit la donnée depuis sa source brute, à travers chaque transformation, jusqu'au tableau de bord final. Cette visibilité est indispensable à la conformité réglementaire, notamment au RGPD, et aide les équipes à vérifier l'exactitude de leurs analyses. Les emplacements managés renforcent encore la conformité en garantissant que les données résident dans les régions géographiques exigées par le droit local.
Concilier liberté des utilisateurs et supervision de l'entreprise
L'un des grands défis de la gestion des données consiste à laisser les équipes innover sans mettre en péril les données de production. Nous recommandons de concevoir des « bacs à sable » dans votre architecture. Ces environnements permettent à vos data scientists d'expérimenter sur des données récentes tout en restant sous le parapluie protecteur des politiques de sécurité. Cette approche évite le scénario « Far West » où les données finissent copiées dans des tableurs non gouvernés. Les intendants de données jouent ici un rôle déterminant : ils font le pont entre équipes techniques et métiers et veillent au maintien de la qualité. Un conseil et une gouvernance Power BI efficaces garantissent que ces jeux de données gouvernés se traduisent en rapports fiables. La mise en place d'un contrôle d'accès fondé sur les attributs (ABAC) fait encore monter votre sécurité en échelle, en accordant les accès selon des caractéristiques comme le service ou le rôle projet. Cela réduit la gestion manuelle des permissions individuelles et rend vos bonnes pratiques Azure Databricks plus soutenables à mesure que vos équipes grandissent.
Réglage des performances : Delta Lake et modélisation
Un environnement de données performant repose sur un stockage efficace et une organisation intelligente. L'une des bonnes pratiques Azure Databricks les plus efficaces consiste à dépasser le partitionnement traditionnel au profit du Liquid Clustering. Le partitionnement fut longtemps la méthode principale pour gagner en rapidité, mais il provoquait souvent une asymétrie des données ou un sur-partitionnement sur des colonnes à faible cardinalité. Le Liquid Clustering simplifie cela en ajustant dynamiquement la disposition des données, ce qui maintient vos requêtes rapides même lorsque vos volumes augmentent. Cette souplesse est essentielle à un Lakehouse réactif, capable de grandir avec votre activité.
Le « problème des petits fichiers » reste un tueur de performance courant. Lorsque des milliers de fichiers minuscules s'accumulent, la seule ouverture de chacun d'eux ralentit fortement les lectures. Nous recommandons d'activer les fonctions d'auto-optimisation, en particulier l'écriture optimisée et le compactage automatique, pour traiter cela sans intervention. En consolidant ces fichiers en arrière-plan, vous conservez une couche de stockage saine sans travail manuel. Cette maintenance proactive garde vos données prêtes pour l'analyse à grande vitesse et réduit la latence des rapports en aval.
Optimiser la couche de stockage Delta
Pour les organisations évoluant dans l'écosystème Microsoft, V-Order change la donne. Il s'agit d'une optimisation à l'écriture qui trie et compresse les données de manière à permettre des lectures extrêmement rapides, en particulier depuis Fabric ou Power BI. Pour garder un environnement sobre, activez la Predictive Optimization : elle prend en charge le nettoyage et le compactage en fonction des usages réels. Elle gère aussi élégamment l'évolution des schémas et vous permet d'ajouter ou de modifier des colonnes sans casser vos pipelines en aval ni réécrire une table entière. Votre architecture reste ainsi souple face à l'évolution de vos besoins.
Modéliser pour l'analytique en aval
Votre stratégie de modélisation doit toujours garder l'utilisateur final en tête. Nous suivons l'architecture Medallion, qui fait passer la donnée de Bronze (brut) à Argent (nettoyé), puis à Or (prêt pour le métier). Concevoir les tables de la couche Or spécifiquement pour le mode DirectLake de Power BI est une étape déterminante en 2026. Power BI lit alors directement les tables Delta depuis OneLake, sans import ni DirectQuery intermédiaire. Suivre ces bonnes pratiques Azure Databricks en matière de modélisation rend vos rapports Power BI non seulement exacts, mais remarquablement rapides.
N'oubliez pas que la performance DAX ne commence pas dans le rapport, mais dans le modèle de données physique de Databricks. Un schéma en étoile propre dans votre couche Or réduit la complexité de vos mesures et accélère l'affichage des visuels. Si vous souhaitez affiner votre architecture, nos équipes peuvent vous aider à mettre en place une conception d'entrepôt de données et de Lakehouse solide. Travaillons ensemble à des modèles pensés dès le départ pour la vitesse et la scalabilité. Optimisez votre modélisation avec notre accompagnement expert dès aujourd'hui.
Faire le pont : intégration de Databricks, Fabric et Power BI
Considérer Databricks comme un outil isolé revient à passer à côté d'une occasion majeure. Dans le paysage actuel, la synergie entre Databricks et OneLake de Microsoft Fabric crée un environnement unifié et puissant, qui supprime les silos traditionnels. En traitant OneLake comme couche de stockage unique, vous utilisez Databricks comme moteur de traitement lourd tout en diffusant les analyses via l'interface accessible de Fabric. Cette intégration est une pierre angulaire des bonnes pratiques Azure Databricks : elle fait en sorte que votre puissance technique se traduise directement en accessibilité métier.
L'une des fonctions les plus déterminantes de cet écosystème est l'usage des raccourcis. Ils permettent à Fabric de pointer directement vers vos tables Delta Databricks, sans copier ni déplacer la moindre donnée. Le risque de duplication disparaît et vos rapports Power BI reflètent toujours le traitement le plus récent. Cette architecture sans copie réduit les coûts de stockage et simplifie la gestion de vos pipelines, ce qui permet à vos équipes de se concentrer sur la logique plutôt que sur les déplacements de données. C'est une manière stratégique de conserver un environnement sobre et performant.
Databricks et Microsoft Fabric : meilleurs ensemble
Utiliser Databricks pour vos traitements Spark complexes tout en diffusant les données via Fabric vous offre le meilleur des deux mondes. Vous disposez de la puissance de calcul brute nécessaire à l'apprentissage automatique avancé et à l'ETL à grande échelle, associée aux capacités de restitution fluides de Power BI. Un modèle de sécurité unifié sur toute la pile Microsoft rend cela possible, Unity Catalog assurant une couche de gouvernance cohérente. Les permissions définies dans votre Lakehouse sont ainsi respectées jusqu'au rapport final. Pour ceux qui préparent une transition, nos services de migration Microsoft Fabric proposent une feuille de route détaillée.
Comment Momentum One renforce votre stratégie
Réussir dans un domaine aussi complexe demande plus que des connaissances techniques : cela demande un partenaire qui comprend comment les pièces s'assemblent. Nous sommes cette main sûre : nous menons des audits architecturaux approfondis pour repérer les goulets d'étranglement de votre configuration. Notre réglage des performances garantit des clusters correctement dimensionnés et des modèles optimisés pour des analyses au plus vite. Nos services managés assurent une supervision continue afin de maintenir la stabilité de votre environnement à mesure que vos volumes augmentent. Il s'agit de transformer une pile technique complexe en actif métier fiable. Modernisez votre architecture de données avec Momentum One pour bâtir un Lakehouse évolutif et pérenne, porteur de valeur réelle.
Les prochaines étapes vers un Lakehouse performant
Bâtir un Lakehouse performant suppose d'allier précision technique et pilotage stratégique. En évoluant vers une architecture gouvernée avec Unity Catalog et en optimisant vos ressources de calcul, vous transformez vos données d'un centre de coûts complexe en actif métier maîtrisé. L'intégration de Databricks avec Microsoft Fabric et Power BI garantit des analyses à la fois profondes et accessibles à toute l'organisation. Appliquer ces bonnes pratiques Azure Databricks est la clé d'une stabilité préservée pendant que vous faites grandir vos initiatives data en 2026.
Microsoft Solutions Partner certifié fort de plus de 8 ans d'expérience des données en entreprise, Momentum One est la main sûre des migrations complexes et du réglage des performances. Nous sommes spécialisés dans l'optimisation DAX et la performance Fabric, pour que votre configuration technique délivre un maximum de valeur métier. Si vous êtes prêt à identifier vos goulets d'étranglement et à affiner votre stratégie, nos équipes sont là pour vous accompagner. Réservez une revue stratégique Azure Databricks pour engager votre modernisation dès aujourd'hui. Votre chemin vers un environnement de données plus rapide et plus sûr commence par une feuille de route claire et un partenaire dédié.
Questions Fréquemment Posées
Quel est le moyen le plus efficace de maîtriser ses coûts dans Azure Databricks ?
Le moyen le plus efficace, dans le respect des bonnes pratiques Azure Databricks, consiste à imposer des politiques de cluster limitant la taille et le type de machines virtuelles accessibles aux utilisateurs. Activez systématiquement l'arrêt automatique pour éviter que des clusters restent inactifs tout en consommant des DBU et de l'infrastructure. Régler ce déclencheur sur 10 ou 15 minutes d'inactivité permet d'économiser une part importante de votre budget. Utiliser des clusters Jobs pour les tâches automatisées revient également bien moins cher que des clusters All-Purpose.
Dois-je choisir Azure Databricks ou Microsoft Fabric pour mon ingénierie des données ?
Le choix dépend de la complexité de vos charges et de l'expertise de vos équipes. Azure Databricks reste supérieur pour du traitement Spark intensif, de la data science complexe et de l'apprentissage automatique à grande échelle. Microsoft Fabric convient mieux aux organisations qui recherchent une expérience SaaS unifiée, étroitement intégrée à l'écosystème Power BI. De nombreuses entreprises réussissent en combinant les deux : Databricks comme moteur, OneLake de Fabric comme couche de stockage centrale.
En quoi Unity Catalog améliore-t-il la sécurité par rapport aux méthodes antérieures ?
Unity Catalog fait passer la sécurité d'un modèle local à l'espace de travail à un cadre centralisé, au niveau du compte. Vous gérez ainsi les permissions globalement sur plusieurs espaces de travail, avec des règles d'accès cohérentes pour chaque utilisateur. Il introduit le contrôle d'accès fondé sur les attributs (ABAC), qui accorde les droits selon des étiquettes comme le service ou le rôle projet. C'est un progrès majeur par rapport aux méthodes antérieures, qui imposaient des réglages manuels et répétitifs pour chaque table et chaque espace de travail, avec le risque d'erreur humaine que cela suppose.
Quelle différence entre Delta Lake et un entrepôt de données traditionnel ?
Delta Lake est une couche de stockage open source qui apporte fiabilité et transactions ACID aux data lakes, tandis qu'un entrepôt traditionnel repose généralement sur un moteur de stockage propriétaire. Contrairement à un entrepôt, Delta Lake conserve vos données dans des fichiers Parquet ouverts, ce qui évite la dépendance à un fournisseur. Vous pouvez exécuter des charges de BI et d'IA sur la même source. Cette architecture offre la performance d'un entrepôt avec la souplesse et l'échelle d'un data lake moderne.
Comment optimiser les performances d'Azure Databricks pour mes rapports Power BI ?
L'optimisation pour Power BI commence par un schéma en étoile propre dans votre couche Or. Activez V-Order sur vos tables Delta pour accélérer les lectures par le moteur Power BI. Le recours au mode DirectLake est une autre étape déterminante : Power BI lit alors les données directement depuis OneLake, sans la latence de DirectQuery ni la charge du mode Import. Ces bonnes pratiques Azure Databricks garantissent à vos utilisateurs métier un affichage et des actualisations extrêmement rapides.
Le calcul serverless est-il toujours le meilleur choix pour les clusters Databricks ?
Le calcul serverless est excellent pour des charges SQL ponctuelles et des requêtes décisionnelles, car il supprime la gestion manuelle des clusters et de la mise à l'échelle. Vous ne payez que la durée exacte d'exécution d'une requête. Pour des traitements ETL lourds, prévisibles et continus, des clusters Jobs traditionnels avec instances réservées ou machines Spot peuvent toutefois rester plus économiques. Analysez vos profils de charge pour déterminer si le confort du serverless l'emporte sur les économies potentielles de clusters gérés.
Quelles erreurs éviter lors d'une migration vers Databricks ?
Une erreur fréquente consiste à transposer du code hérité sans le refondre pour l'architecture distribuée de Spark, ce qui débouche souvent sur de mauvaises performances et des coûts élevés. Autre écueil : négliger la gouvernance dès le départ. Déployez Unity Catalog immédiatement pour éviter de créer des silos non gouvernés. Enfin, ne sous-estimez pas le double modèle de facturation : l'absence de politiques de cluster et d'arrêt automatique se traduit souvent par des dépenses cloud inattendues durant les premiers mois.