Modernisation de la plateforme de données : préparer les données pour l’analyse cloud
La modernisation des plateformes de données va au-delà de la migration vers le cloud. Apprenez à préparer les données, les pipelines, la gouvernance et l’architecture cloud pour des analyses évolutives et fiables.
- La modernisation implique bien plus que le simple transfert de données vers le cloud : aligner la plateforme, la gouvernance et l’environnement analytique sur les besoins de l’entreprise.
- Utilisez le profilage et le nettoyage pour identifier les problèmes de qualité avant la migration, puis transformez les données pour les adapter à leur usage prévu.
- Concevez une architecture cloud basée sur les flux de données, les exigences de charge de travail et les performances afin que la plateforme puisse évoluer efficacement.
- Reliez des données bien modélisées à des outils d’analyse pour soutenir des rapports plus clairs et des analyses plus fiables.
- Découvrez comment Microsoft Fabric et Power BI peuvent fonctionner ensemble, et où la migration, la modélisation et la conception de lakehouse soutiennent cette transition.
Un déplacement cloud seul ne modernise pas une plateforme de données. La modernisation des plateformes de données signifie préparer et remodeler les données, les pipelines, l’architecture et la gouvernance afin que l’analytique cloud puisse soutenir des analyses fiables, une échelle et la qualité des données. Le travail inclut l’évaluation des systèmes existants, la planification de la migration et la validation des données au fur et à mesure de leur déplacement.
Si vos données sont réparties entre plusieurs systèmes ou si votre plateforme actuelle rend l’analyse difficile à mettre à l’échelle, il peut être difficile de savoir par où commencer. Cette incertitude est compréhensible : la modernisation réussie de la plateforme de données dépend de plus que le simple choix d’une plateforme cloud. La préparation des données, les priorités métier, la sécurité et la conception de l’environnement cible comptent tous.
Cet article explique en quoi consiste la modernisation des données et comment la préparation, la migration et l’architecture cloud s’intègrent. Vous apprendrez comment une plateforme moderne peut soutenir l’analytique, la scalabilité et la qualité des données, ainsi que ce qu’il faut prendre en compte lors de la planification de la transition.
Qu’est-ce que la modernisation des données ?
La modernisation des données remodele l’environnement de données d’une entreprise pour répondre aux charges de travail, aux besoins d’analyse et de gouvernance actuels. Elle peut impliquer une migration, une architecture repensée, des contrôles renforcés et une meilleure propriété des actifs de données.
Gouvernance, sécurité et contrôles d’accès
La gouvernance des données définit qui possède, accède, protège et gère les données tout au long de leur cycle de vie. Ces contrôles sont importants lors de la modernisation car la migration peut modifier l’emplacement de l’information et les charges de travail qui les utilisent. Au Luxembourg, le RGPD est un règlement pertinent à considérer lors de la cartographie des actifs de données. La gouvernance doit relier chaque actif à son propriétaire, aux utilisateurs autorisés, à la sensibilité et à l’objectif approuvé.
Intégrez les contrôles de sécurité dans la conception de la migration, plutôt que de les laisser pour une révision finale. Par exemple, attribuez l’accès par rôle, limitez les autorisations aux tâches requises et conservez les enregistrements d’audit des accès et modifications importants. Les catalogues de données peuvent aider les équipes à identifier les actifs et les classifications. Des audits de sécurité réguliers et des politiques testées peuvent révéler des vulnérabilités avant que de nouvelles charges de travail ne dépendent des données migrées.
Fondements modernes des données et technologies de gouvernance
Une base de données moderne combine des données bien organisées, des pipelines reproductibles et des technologies de gouvernance qui soutiennent une utilisation contrôlée. Les outils de migration déplacent et transforment les dossiers ; les catalogues, contrôles d’accès et capacités d’audit aident les équipes à les gérer par la suite. Un transfert réussi à lui seul ne rend pas les données fiables ou correctement gouvernées. Les organisations au Luxembourg doivent prendre en compte le RGPD en parallèle des besoins métier et des exigences techniques.
Commencez à planifier avec un inventaire des sources de données, entrepôts, pipelines et systèmes de rapports. Associez chaque actif à son propriétaire, à son objectif, à ses besoins en qualité et à sa charge de travail cible. Les sauvegardes et validations lors de la migration aident à protéger l’intégrité et à réduire le risque de perte ou de corruption. Par exemple, comparez les enregistrements source et destination après un transfert, enquêtez sur les incompatibilités et résolvez-les avant que les rapports ne dépendent du nouvel environnement.
Les technologies de gouvernance peuvent centraliser l’application des politiques et l’audit, tandis qu’un catalogue de données facilite la recherche et l’interprétation des actifs. Ces capacités sont utiles lorsque plusieurs équipes utilisent les mêmes informations pour différentes charges de travail. Un enregistrement client, par exemple, peut supporter des rapports opérationnels et des analyses, mais chaque utilisation nécessite toujours un accès et une propriété définis. Des métadonnées claires aident également les équipes à comprendre la lignée, les transformations et l’origine des chiffres rapportés.
L’ampleur de la modernisation varie selon les systèmes existants et les résultats visés. Cette diversité illustre pourquoi les équipes devraient d’abord définir le périmètre, les dépendances et les priorités métier. Au Luxembourg, la migration, la conception de gouvernance et les contrôles de sécurité sont des composantes pertinentes du travail ; le RGPD est une considération réglementaire pertinente. Un guide de migration Microsoft Fabric peut aider à structurer la transition de la plateforme en fonction de ces fondations.
Nettoyage, profilage et transformation avant la migration
Évaluez une plateforme héritée en comparant ses sources de données, entrepôts, pipelines et rapports avec les objectifs métier et techniques. Documentez les dépendances des documents, les propriétaires de données, les problèmes de qualité, les charges de travail et les contraintes de migration. Cet inventaire révèle quels actifs soutiennent les opérations essentielles et quelles transformations nécessitera l’analytique.
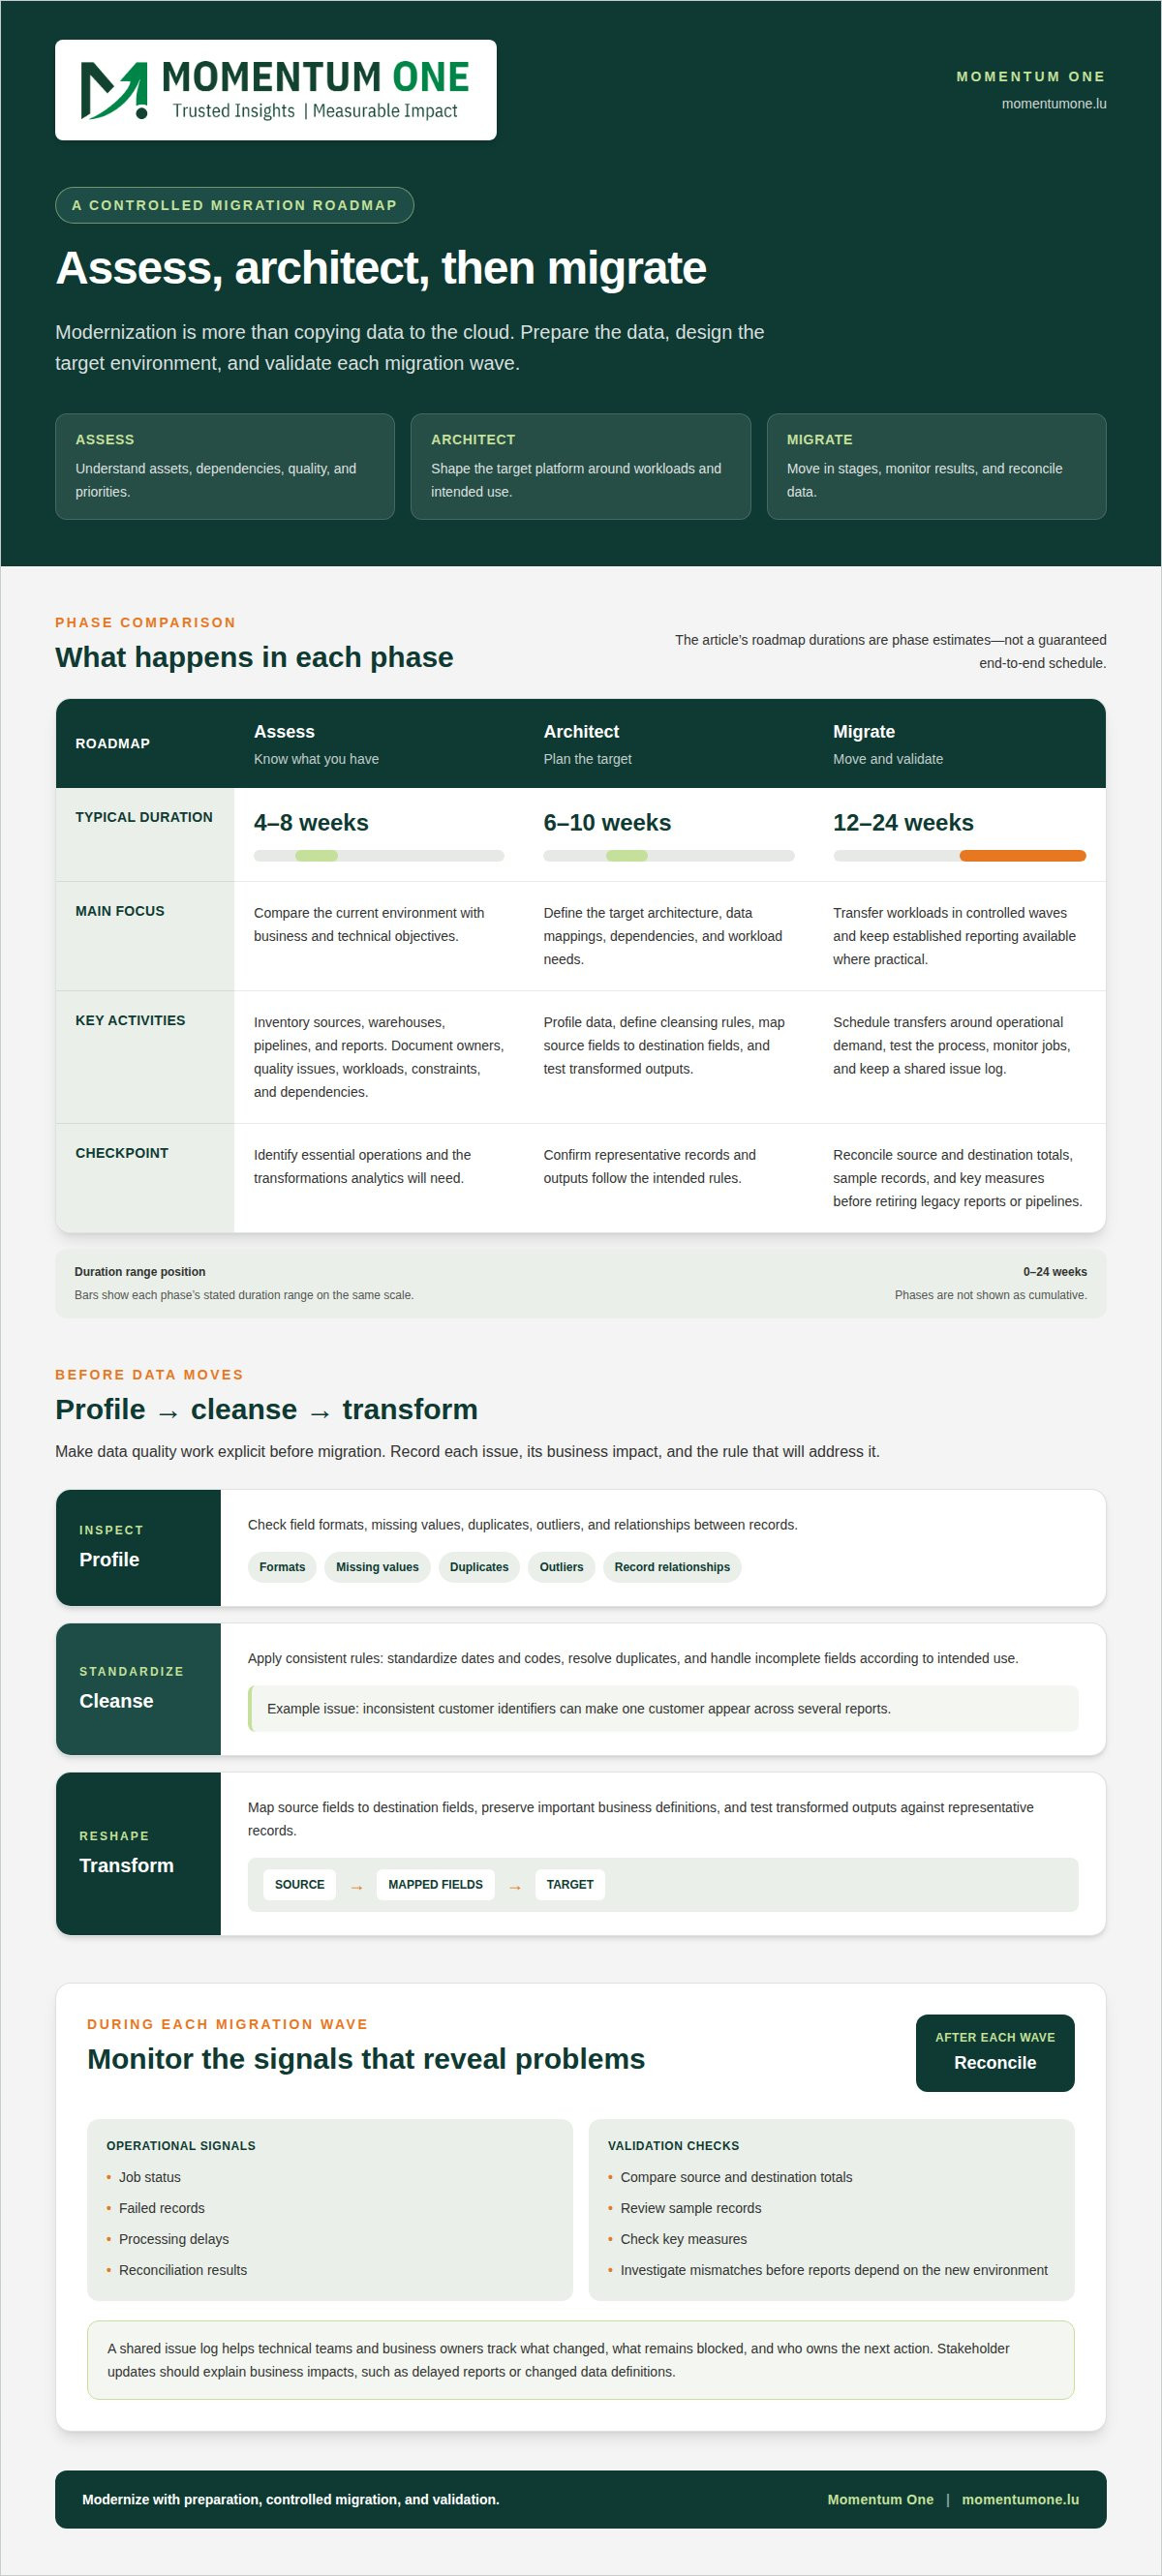
Les coûts dépendent de la portée, de la complexité, de l’état des données et de l’architecture cible. Une feuille de route donne un calendrier plus clair : la phase d’évaluation prend généralement 4 à 8 semaines, celle de l’architecte 6 à 10 semaines, et la migration de 12 à 24 semaines. Ces durées décrivent des phases, pas un calendrier garanti de bout en bout.
Le profilage établit ce que contiennent les données sources avant que les équipes ne les remodelent. Examinez les formats de champs, les valeurs manquantes, les doublons, les valeurs aberrantes et les relations entre les enregistrements. Par exemple, des identifiants clients incohérents peuvent faire apparaître un client dans plusieurs rapports. Enregistrez chaque problème, son impact sur l’entreprise, et la règle qui le traitera.
Le nettoyage applique ces règles de manière cohérente. Standardisez les dates et codes, résolvez les doublons et traitez les champs incomplets selon leur usage prévu. La transformation reconfigure ensuite les données nettoyées pour la plateforme cible. Définissez les mappages entre les champs source et destination, conservez les définitions métier importantes et testez les sorties transformées contre des enregistrements représentatifs.
Planifiez la migration en étapes, en fonction des dépendances et de l’importance métier. Déplacez d’abord une charge de travail délimitée, validez-la, puis étendez vers les actifs connectés. Planifiez les transferts en fonction de la demande opérationnelle, testez le processus et utilisez des systèmes parallèles lorsque cela est possible. Cela permet aux équipes de comparer les résultats et de maintenir l’accès aux rapports établis pendant la transition.
Associez la surveillance des migrations aux signaux opérationnels clairs : statut du poste, dossiers défaillants, retards de traitement et résultats de rapprochement. Un journal des problèmes partagé aide les équipes techniques et les chefs d’entreprise à voir ce qui a changé, ce qui reste bloqué et qui détient la prochaine action. Des mises à jour régulières des parties prenantes doivent expliquer les impacts en termes métier, tels que des rapports retardés ou des définitions de données modifiées.
Après chaque vague de migration, rapprochez les totaux source et destination, les enregistrements d’échantillons et les mesures clés. Enquêtez sur les inadéquations avant de retirer les rapports hérités ou les pipelines. L’audit des règles de cartographie et de transformation enregistre également la production des résultats. La formation peut ensuite montrer aux utilisateurs des rapports d’où proviennent les données et comment les définitions modifiées affectent leur analyse.
Une feuille de route pratique relie le travail : évaluer l’environnement actuel, concevoir la cible, migrer en vagues contrôlées et valider chaque résultat. Examiner les progrès avec les parties prenantes et ajuster le séquençage lorsque des dépendances ou des problèmes de qualité des données apparaissent. Cela permet de garder les décisions connectées aux priorités métier, plutôt que de traiter la migration comme une simple opération de copie.
Architecture des plateformes cloud et optimisation des performances
L’architecture cloud détermine comment les données circulent, où elles sont stockées et comment elle supporte les charges de travail analytiques. Un design solide relie les capacités de la plateforme aux besoins métier tout en maintenant la performance visible et gérable.
Adoption du cloud et gestion des données
L’adoption cloud déplace les charges de travail de données vers des environnements cloud, où l’architecture et les pratiques opérationnelles influencent la gestion des équipes. Des pipelines évolutifs et cloud-first supportent l’ingestion et la transformation des données à mesure que la demande évolue. Par exemple, séparer l’ingestion des rapports permet aux équipes d’ajuster une charge de travail sans repenser l’environnement complet.
Les choix d’architecture doivent refléter les sources de données, les schémas de traitement et les exigences analytiques. Évaluez où les données sont créées, à quelle vitesse elles doivent être disponibles, et quelles transformations supportent le reporting de rapports. Ces décisions guident les schémas de stockage et de traitement, tandis que la surveillance révèle des goulots d’étranglement tels que l’ingestion lente ou des requêtes inefficaces.
L’optimisation des performances est une activité de conception continue. Examinez les étapes du pipeline, les schémas de requête et la demande de charge de travail, puis ajustez la partie qui limite l’expérience utilisateur. Une plateforme cloud peut évoluer sur les capacités, mais la mise à l’échelle seule ne corrigera pas les transformations mal conçues ni les déplacements de données inutiles.
Approches hybrides et multi-cloud
Une architecture cloud-native est conçue autour des services cloud, tandis qu’un environnement hybride relie le cloud aux systèmes existants. Les conceptions multi-cloud utilisent des services à travers des environnements cloud. Chaque approche influence la manière dont les données circulent, comment les équipes gèrent les pipelines et où les contrôles de gouvernance doivent s’appliquer.
Pour une conception hybride, définissez quelles charges de travail restent dans les environnements existants et lesquelles passent au cloud. Cartographiez les dépendances entre eux, puis concevez des flux de données sécurisés et observables. Une approche multi-cloud nécessite également une propriété claire des intégrations et des définitions cohérentes, afin que les utilisateurs puissent interpréter les données de manière fiable sur toutes les plateformes.
Choisissez une approche basée sur la charge de travail réelle et le modèle opérationnel, et non sur son label. Un rapport qui dépend de données sources fréquemment actualisées, par exemple, peut nécessiter une conception de pipeline différente d’une analyse historique périodique. Documenter ces schémas aide les équipes à planifier la capacité et à identifier les problèmes de performance.
Technologies de plateforme et compétences de projet
Les entrepôts de données, les datalakes et les architectures lakehouse prennent en charge différents besoins de stockage et d’analyse. Un lakehouse réunit les capacités de data-lake et d’entrepôt pour soutenir des analyses évolutives. Microsoft Fabric unifie l’ingénierie des données, l’analyse et l’intelligence économique, aidant les équipes à relier la conception de plateforme aux besoins en rapports.
Les rôles courants des projets incluent les architectes de données, les ingénieurs, les spécialistes de la gouvernance et de la sécurité, ainsi que les responsables de l’analytique. Les architectes façonnent les environnements et les schémas d’intégration ; les ingénieurs construisent et ajustent les pipelines. Les spécialistes de la gouvernance définissent l’accès et les contrôles, tandis que les parties prenantes métier clarifient les priorités de charge de travail et valident que les résultats supportent des décisions concrètes.
Lors de l’examen d’une étude de cas d’intégration de données Informatica Cloud, concentrez-vous sur son architecture, ses exigences d’intégration et ses mesures de performance. Considérez quelles sources et cibles étaient connectées, comment les transformations étaient gérées et comment les équipes surveillaient les défaillances. Cela fait d’une étude de cas une référence de conception utile sans supposer que ses résultats s’appliqueront à tous les environnements.
Relier le travail de performance à l’impact utilisateur. Suivre la complétion du pipeline, la réactivité des requêtes et la fraîcheur des données selon les besoins de chaque charge de travail. Une équipe de modernisation peut ensuite prioriser les changements, les tester avec des charges de travail représentatives et documenter l’architecture résultante pour les opérations en cours.
Avantages pour l’analytique, la scalabilité et la qualité des données
Les bases de données modernes connectent des informations provenant de sources distinctes et les rendent plus utiles pour l’analytique. La valeur réside dans la combinaison de données accessibles, de définitions cohérentes et de capacités de traitement adaptées à chaque charge de travail. Une équipe commerciale, par exemple, peut utiliser une vue partagée des commandes et de l’activité client au lieu de rapprocher manuellement des rapports séparés.
Un lakehouse combine des capacités de data-lake et d’entrepôt de données pour soutenir des analyses évolutives. Il peut rassembler des sources de données variées pour des rapports structurés et des analyses plus larges. Cette base aide les équipes à explorer des informations détaillées sans maintenir un environnement entièrement séparé pour chaque utilisation. L’architecture nécessite toujours des modèles de données clairs, une propriété et des règles de qualité, afin que l’accès partagé produise des insights cohérents.
La qualité des données affecte directement la fiabilité des analyses et des résultats prédictifs. Si les identifiants de produit varient selon les systèmes sources, les rapports peuvent diviser un élément en plusieurs catégories. Le profilage, la standardisation et la validation aident à résoudre ces problèmes avant que les utilisateurs métier ne s’appuient sur les résultats. Les équipes peuvent également surveiller la fraîcheur et l’exhaustivité, puis retracer des chiffres inattendus via des transformations jusqu’à leur source.
La scalabilité aide une plateforme à gérer l’évolution des volumes de données et la demande analytique. Le traitement cloud peut être conçu en fonction des exigences de charge de travail, plutôt que de forcer chaque tâche à passer par le même pipeline rigide. Le traitement par lots hérité et les pipelines ETL rigides peuvent retarder les décisions lorsque les équipes ont besoin d’informations plus fraîches. Reconstruire des pipelines avec des designs évolutifs et cloud-first favorise une ingestion et une transformation plus rapides.
L’analyse en temps réel peut rendre les signaux opérationnels utiles plus rapidement. Par exemple, des données d’équipement en temps opportun peuvent aider les équipes à identifier des schémas qui méritent d’être examinés, tandis que les modèles prédictifs peuvent éclairer la planification de la maintenance. Gogo a obtenu une baisse de 75 % de son taux de non-faute trouvée grâce à l’analyse prédictive du Big Data. Ce résultat illustre un cas d’usage spécifique, et non un résultat promis pour chaque organisation.
L’intelligence économique devient plus fiable lorsque les rapports partagent des définitions gouvernées et des données bien modélisées. Un fournisseur mondial de fabrication a rapporté avoir augmenté son score de confiance dans les prévisions de ventes de 20 % à 90 %. L’exemple montre comment des données et des analyses améliorées peuvent soutenir la planification, mais les mesures pertinentes dépendent de chaque décision métier. Les équipes doivent relier les indicateurs de rapport à des définitions claires et à des sources fiables.
La préparation de l’IA dépend également de données accessibles, pertinentes et décrites de manière cohérente. Avant d’appliquer l’intelligence artificielle, les équipes doivent comprendre d’où provient l’information, comment elle évolue et si elle convient à l’analyse prévue. Une séquence pratique consiste à définir le cas d’usage, identifier les sources nécessaires, évaluer la qualité et établir des transformations répétables. Cela donne aux travaux analytiques et IA une base plus claire, tout en rendant les limites des données visibles avant qu’elles ne déforment les résultats.
Analyse Microsoft Fabric et intégration Power BI
Microsoft Fabric réunit l’ingénierie des données, l’analytique et l’intelligence économique. Power BI peut utiliser des données préparées pour transformer des sources intégrées en rapports et insights gouvernés.
Intégration, qualité et entreposage des données
L’intégration des données combine des informations provenant de différentes sources, tandis que l’entrepôt les organise pour analyse. Ensemble, elles aident les équipes à travailler à partir de données cohérentes plutôt que d’extraits déconnectés. Par exemple, les ordres et les détails clients peuvent être alignés avant que les analystes ne construisent des rapports de ventes, réduisant ainsi les définitions conflictuelles entre les tableaux de bord.
Intégrez les contrôles de qualité dans le flux d’intégration. Validez les champs requis, standardisez les formats et investiguez les valeurs inattendues avant de charger les données pour les rapports. Un entrepôt ou un lakehouse peut alors fournir une base structurée pour l’analytique. Sa conception doit refléter la manière dont les équipes interrogent les informations, les données dont elles ont besoin et comment les contrôles de gouvernance s’appliquent.
Les rapports Power BI reposent sur ces fondations. Un modèle clair relie les mesures aux définitions métier, donc les totaux de ventes signifient la même chose entre les rapports. Pour les charges de travail réglementées, alignez l’accès et l’audit sur les politiques de gouvernance, y compris les exigences de confidentialité pertinentes telles que le RGPD.
Pipelines de données unifiés
Les pipelines unifiés coordonnent le mouvement et la transformation des données à travers un processus cohérent et observable. Dans Microsoft Fabric, les capacités d’ingénierie des données connectées et d’analyse peuvent soutenir le flux des systèmes sources vers les rapports. Cela est important lorsque des pipelines manuels séparés dupliquent la logique ou rendent les modifications difficiles à retracer.
Mapper chaque pipeline à sa source, transformation, destination et rapport en aval. Par exemple, un jeu de données client peut combiner les enregistrements des systèmes de vente et de service avant de supporter un tableau de bord Power BI. Surveillez les défaillances des pipelines et la fraîcheur des données, et clarifiez la propriété afin que la bonne équipe puisse résoudre les problèmes.
Les équipes qui maintiennent 100+ pipelines manuels peuvent gagner du temps d’ingénierie en consolidant et en simplifiant leurs pratiques de pipeline. L’objectif n’est pas de combiner chaque flux de manière indiscriminée. Regrouper les pipelines par objectif métier et dépendance, puis standardiser les transformations répétables tout en préservant les distinctions requises par les rapports.
ETL et intégration ELT
L’ETL extrait, transforme, puis charge les données ; L’ELT charge les données avant de les transformer dans la plateforme cible. Le choix influence l’endroit où le traitement se produit et la manière dont les équipes gèrent la logique de transformation. Les équipes peuvent, par exemple, nettoyer les champs sensibles avant le chargement, ou charger des données brutes et les transformer pour un usage analytique défini.
Choisissez le motif selon les contraintes de source, les capacités cibles, les contrôles qualité et le besoin de données fraîches de la charge de travail. Dans les deux cas, des règles de transformation de document et des sorties représentatives de test. Cela facilite le traçage d’une mesure Power BI à travers son modèle et son pipeline jusqu’à la source originale.
Une intégration bien planifiée peut accélérer l’analyse et créer une marge d’innovation sans perdre de vue la qualité des données. Si vous élaborez une feuille de route Fabric et Power BI, discutez de vos besoins en intégration des données.
Momentum One : migration et modernisation du Fabric
Momentum One aide les organisations à planifier et à mettre en œuvre la migration et la modernisation de Microsoft Fabric en fonction de leurs besoins analytiques. Faites appel à ce support lorsque des environnements de données hérités, des pipelines déconnectés ou des exigences de reporting rendent la transition cloud difficile à coordiner.
Le travail peut inclure la mise en place d’une approche de migration, la conception d’un entrepôt de données ou d’un lakehouse, et l’alignement des modèles de données et du DAX avec les cas d’usage Power BI. La formation peut également aider les équipes à acquérir les compétences nécessaires pour travailler en confiance avec la plateforme modernisée. La bonne orientation dépend de votre architecture existante, de la qualité des données et des charges de travail prévues.
Si vous envisagez une transition vers Fabric ou d’affiner une plateforme d’analyse existante, contactez Momentum One pour discuter de vos objectifs.
Construire une voie claire vers l’analytique cloud
L’étape suivante consiste à transformer les priorités de modernisation en un plan de plateforme que vos équipes pourront exploiter et développer. Relier l’architecture aux décisions que les personnes doivent prendre, puis attribuer la propriété des données, des modèles et des rapports qui soutiennent ces décisions. Cela permet de garder les choix technologiques ancrés sur des résultats pratiques.
Momentum One soutient ce travail grâce à la migration et la modernisation Fabric, la stratégie analytique et la gouvernance, ainsi que la modélisation des données et l’optimisation DAX. Ces services peuvent aider à aligner la migration, la gouvernance et la couche analytique à mesure que votre organisation fait progresser ses plans de modernisation de la plateforme de données.
Que vous définissiez une feuille de route ou que vous abordiez un défi spécifique dans un environnement existant, une discussion ciblée peut aider à clarifier les priorités et les prochaines étapes. Contactez Momentum One pour discuter de la modernisation et définir une voie pratique vers vos objectifs d’analyse cloud.
Questions Fréquemment Posées
Qu’est-ce que la modernisation des plateformes de données et quels en sont les avantages ?
La modernisation des plateformes de données met à jour la manière dont une organisation stocke, traite et utilise les données, rendant l’analytique plus adaptable aux besoins changeants. Un avantage pratique est de connecter les informations opérationnelles et historiques pour soutenir des décisions telles que la planification des stocks. La modernisation peut également faciliter la gestion des rapports à mesure que les équipes et les questions métier évoluent. Les avantages dépendent de l’alignement de la conception de la plateforme avec le travail réel, plutôt que de déplacer les processus existants inchangés.
Quelles sont les étapes clés d’une feuille de route pour la modernisation des plateformes de données ?
Une feuille de route utile passe des priorités métier aux décisions d’architecture, puis à la mise en œuvre contrôlée et au transfert opérationnel. D’abord, définissez les décisions et rapports que la plateforme doit supporter. Ensuite, cartographiez les dépendances et sélectionnez un design cible. Définissez des critères d’acceptation avant la migration, tels que la compatibilité des rapports critiques et la possibilité que les propriétaires accèdent aux données dont ils ont besoin. Après la publication, attribuez la responsabilité de la surveillance, de la gestion des problèmes et des changements de plateforme afin que la modernisation devienne une partie des opérations en cours.
Comment les entrepôts de données cloud se comparent-ils aux datalakes et aux lakehouses ?
Un entrepôt de données cloud organise les données pour des requêtes structurées et des rapports, tandis qu’un data lake peut contenir des données variées sous sa forme originale ou transformée. Un lakehouse combine les caractéristiques des deux, en supportant des données diverses en plus de l’analytique. Par exemple, les équipes financières peuvent privilégier des rapports cohérents et modélisés, tandis que les équipes de data science peuvent avoir besoin d’un matériel source plus large. Choisissez selon les formats de données, les modes d’accès, les besoins de gouvernance et les charges de travail que la plateforme doit supporter.
Comment les organisations peuvent-elles migrer les données et les charges de travail avec un minimum de temps d’arrêt ?
Réduisez les perturbations en convenant des critères de basculement avant de passer les utilisateurs au nouvel environnement. Pour une charge de travail de reporting financier, les équipes peuvent comparer les résultats clés de la plateforme cible tant que les rapports établis restent disponibles. Définissez qui approuve le changement, comment les divergences non résolues sont gérées, et comment les opérations reprennent en cas d’échec d’une dépendance critique. Indiquez aux utilisateurs quels rapports sont affectés et quand, puis retirez l’ancien chemin seulement après avoir rempli les critères d’acceptation.
Quels sont les principaux risques et défis de la modernisation d’une plateforme de données ?
Les risques courants incluent des dépendances négligées, des définitions incohérentes, des erreurs d’accès et des problèmes de performance qui apparaissent sous des charges de travail réelles. Un tableau de bord commercial peut se charger correctement mais afficher des totaux différents si sa correspondance source a changé. Gérez ces risques avec des propriétaires nommés, des définitions documentées, des autorisations basées sur des rôles et des tests basés sur la charge de travail. L’adoption par les utilisateurs est un autre défi : expliquez les métriques et flux de travail modifiés aux consommateurs qui rapportent, et leur fournir un moyen clair de signaler les problèmes après la transition.