Requêtes plus rapides : optimisez vos tables Delta de lakehouse
Apprenez à optimiser vos tables Delta de lakehouse dans Microsoft Fabric. Réglez le problème des petits fichiers, accélérez Power BI et réduisez vos coûts grâce à nos
- Comprenez comment le « problème des petits fichiers » pèse sur la latence en lecture et apprenez à résoudre les goulets d'étranglement de métadonnées qui ralentissent vos rapports Power BI.
- Découvrez comment optimiser vos tables Delta de lakehouse avec V-Order et Z-Order pour équilibrer performance d'ingestion et rapidité des requêtes.
- Maîtrisez les commandes de maintenance essentielles comme OPTIMIZE et VACUUM pour garder un stockage sobre et éviter les envolées de coûts de capacité Fabric.
- Apprenez à automatiser ces flux techniques avec les pipelines Fabric Data Factory et les notebooks, pour des performances homogènes dans toute l'entreprise.
- Passez d'un dépannage réactif à une conception architecturale proactive, pour une plateforme qui monte en charge durablement dans le paysage de 2026.
Et si votre consommation de capacité Microsoft Fabric ne tenait pas au volume de données, mais à la manière dont elles sont stockées ? Vous avez sans doute connu la frustration de voir un visuel Power BI tourner pendant que vos unités de capacité grignotent votre budget. C'est une difficulté courante pour les équipes luxembourgeoises qui veulent développer leur analytique sans envolée des coûts. Gérer le « problème des petits fichiers » peut ressembler à un combat perdu d'avance quand vos temps d'actualisation ne cessent d'augmenter. Pour y répondre, il faut optimiser vos tables Delta de lakehouse par une approche de gouvernance stratégique plutôt que par un réglage réactif.
Nous sommes là pour vous aider à combler l'écart entre stockage brut et décisionnel rapide. Ce guide dévoile des techniques de niveau professionnel pour rationaliser votre environnement, réduire la latence et abaisser vos coûts grâce à l'optimisation des tables Delta. Nous verrons comment mettre en place des pipelines de maintenance automatisés et tirer parti des runtimes Fabric de 2026 pour une analytique interactive plus rapide. À la fin de cet article, vous disposerez d'une feuille de route claire vers des coûts de capacité prévisibles et une plateforme plus réactive, au service de toute votre organisation.
L'écart de performance : pourquoi vos tables Delta doivent être optimisées
Beaucoup d'organisations luxembourgeoises voient leur enthousiasme initial pour Microsoft Fabric se heurter rapidement à un plafond de performance. En 2026, le volume des données d'entreprise interdit de s'en remettre aux seuls réglages par défaut. Pour véritablement optimiser vos tables Delta de lakehouse, vous devez d'abord comprendre l'« écart de performance » structurel qui apparaît lorsque le stockage n'est pas géré de manière proactive. Cet écart n'est pas une subtilité technique : c'est un moteur direct de coûts et de frustration.
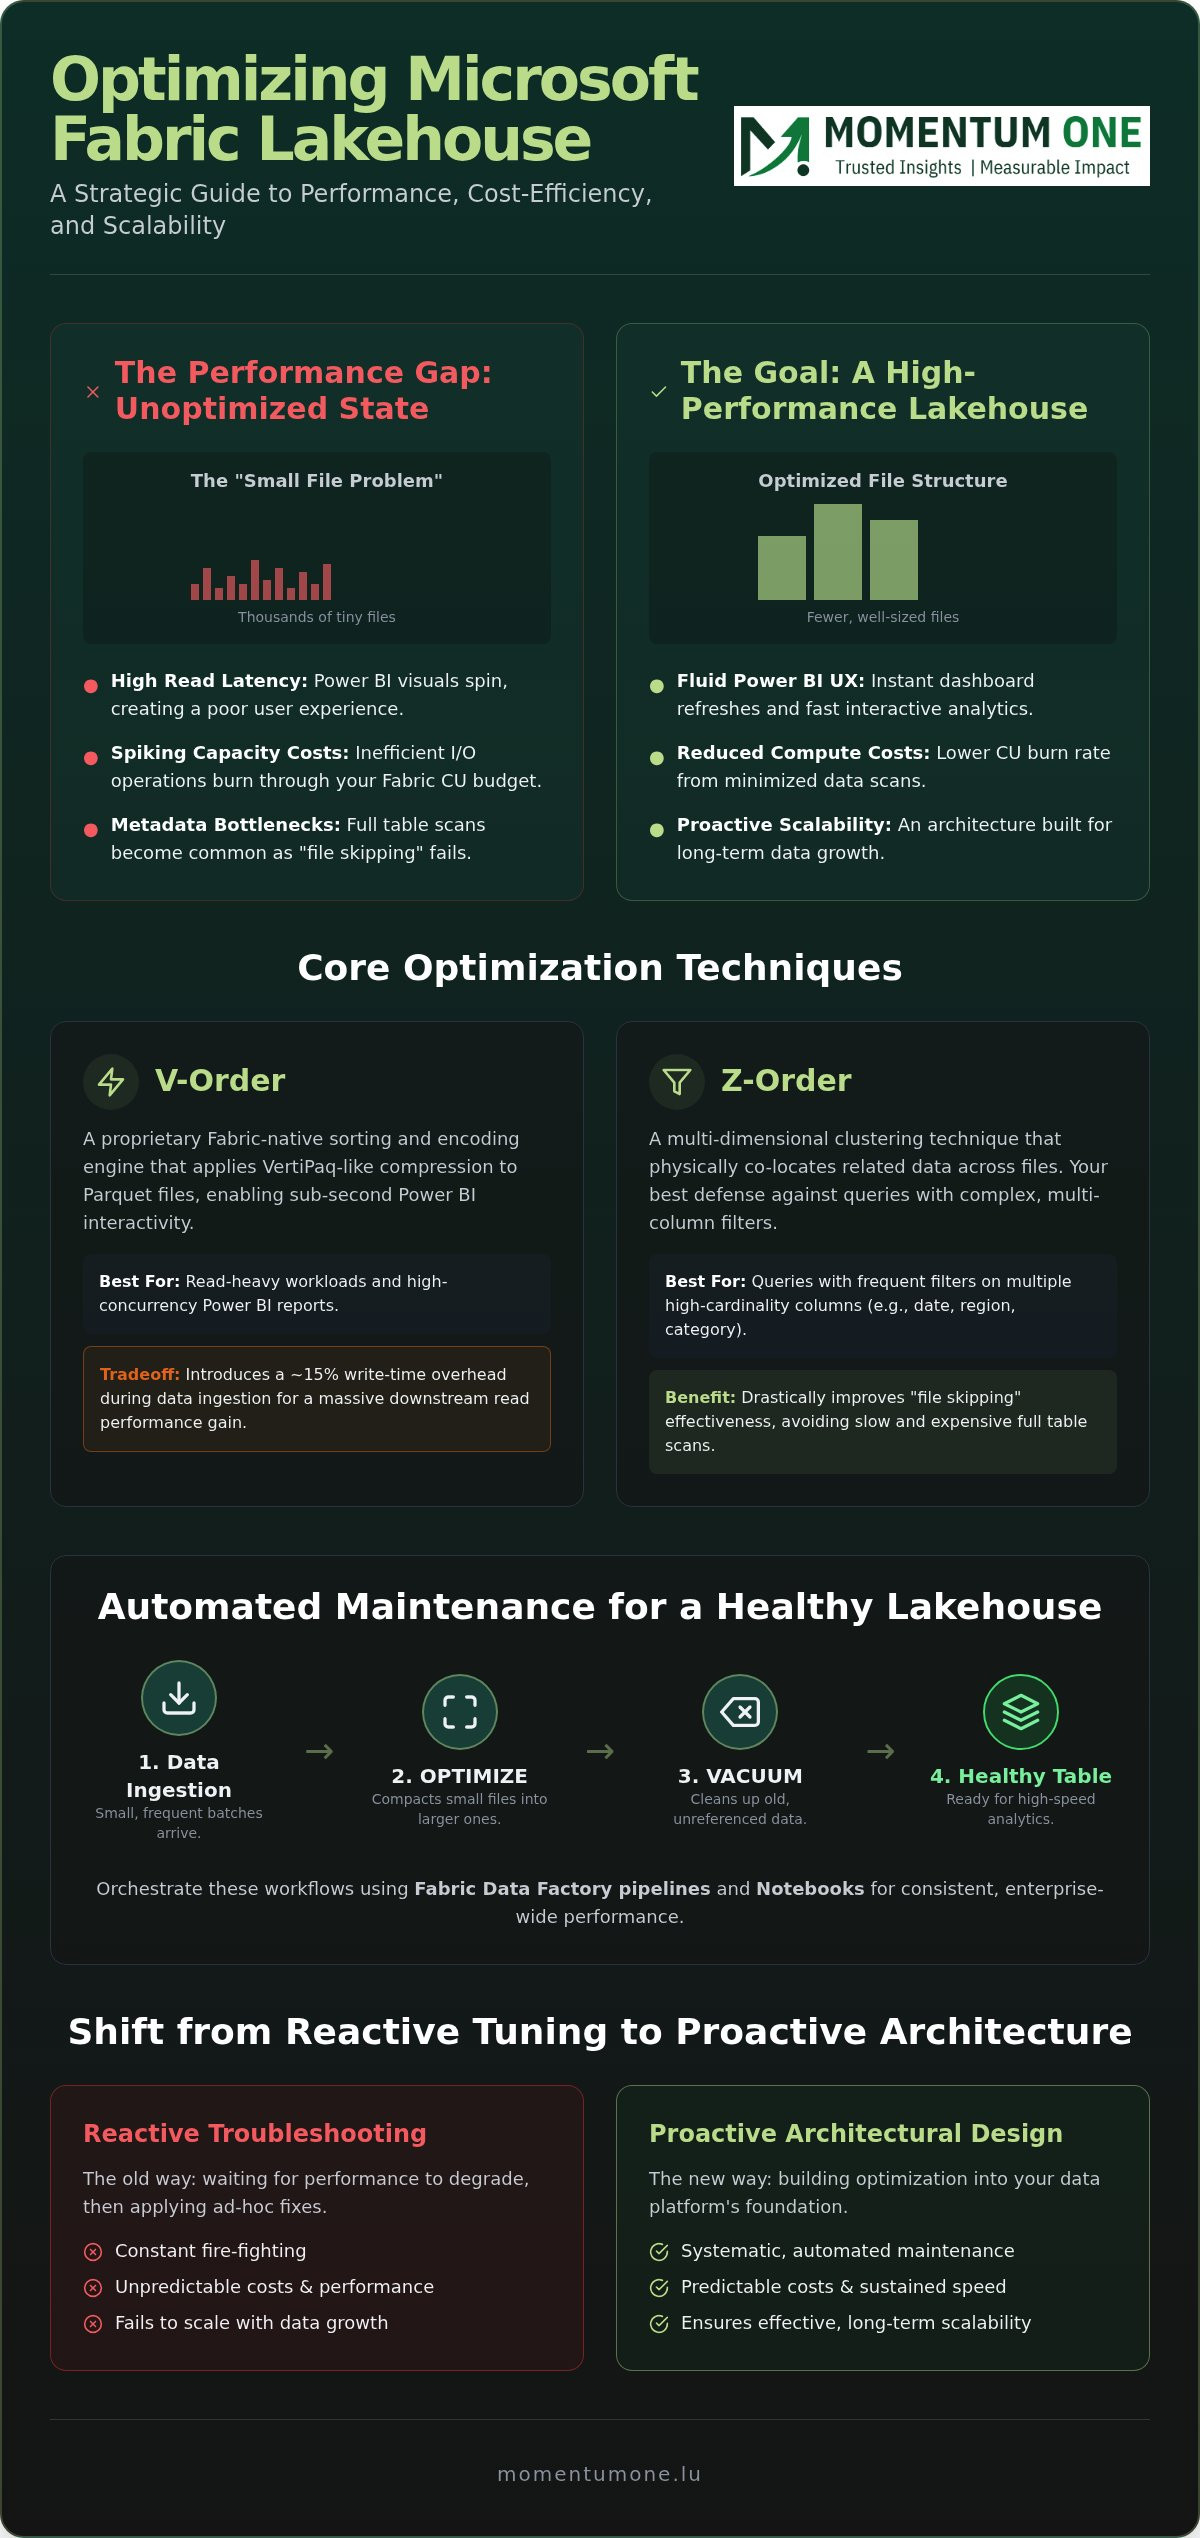
Le coupable le plus fréquent est le « problème des petits fichiers ». Lorsque les données arrivent par petits lots fréquents, le Lakehouse accumule des milliers de minuscules fichiers Parquet. Chacun exige une opération d'entrée-sortie distincte. Pour un rapport Power BI, cela signifie que le moteur passe plus de temps à ouvrir et refermer des fichiers qu'à traiter des données. Cette inefficacité pèse directement sur vos unités de capacité Fabric. Chaque cycle de lecture superflu alourdit votre consommation mensuelle et transforme une négligence technique mineure en charge financière notable.
Au-delà de la taille des fichiers, des métadonnées mal optimisées peuvent paralyser vos requêtes. Delta Lake s'appuie sur le « saut de fichiers » pour ignorer les données qui ne correspondent pas à vos filtres. Si la disposition de vos données est désordonnée, le moteur ne peut plus sauter efficacement, ce qui provoque des analyses complètes de table. Dans un environnement d'entreprise en 2026, ces analyses sont tout simplement trop lentes et trop coûteuses. Le réglage manuel n'est plus une voie tenable face à des lakehouses de plusieurs pétaoctets : il vous faut une approche systématique.
Anatomie d'une table Delta performante
Une table saine ne se juge pas à sa seule taille, mais à sa structure interne et à la façon dont le moteur interagit avec elle. Trois piliers déterminent sa santé :
- La santé des groupes de lignes : des fichiers Parquet optimaux comportent des groupes de lignes bien dimensionnés, alignés sur les tampons mémoire, pour que le moteur lise les données par blocs efficaces.
- Le journal Delta : ce journal de transactions est le cerveau de votre table. S'il se gonfle de milliers d'entrées minuscules, la planification des requêtes finit par durer plus longtemps que leur exécution.
- L'identification des goulets d'étranglement : vous repérez les tables problématiques en cherchant celles dont le nombre de fichiers est disproportionné par rapport au volume total de données.
Le retour sur investissement d'une optimisation stratégique
Investir dans un plan de migration et modernisation Fabric stratégique garantit que vous optimisez vos tables Delta de lakehouse par construction, et non après coup. Un réglage réfléchi apporte des bénéfices nets :
- Des coûts de calcul réduits : en limitant les analyses de données, vous abaissez la consommation d'unités de capacité de chaque requête et de chaque actualisation.
- Une expérience Power BI fluide : des lectures de tables plus rapides font que vos tableaux de bord de direction s'actualisent instantanément, même avec des mesures DAX complexes.
- Une scalabilité à l'échelle nationale : à mesure que votre empreinte de données grandit au Luxembourg, une stratégie d'optimisation normalisée prévient la dégradation des performances avant qu'elle ne survienne.
Exploiter V-Order et Z-Order pour les charges à forte lecture
Pour vraiment optimiser vos tables Delta de lakehouse dans des environnements à forte concurrence, il faut aller au-delà de la simple gestion de fichiers. Microsoft a conçu V-Order comme un moteur propriétaire de tri et d'encodage, spécifique à l'écosystème Fabric. Il applique aux fichiers Parquet une compression proche de VertiPaq et les rend « natifs Fabric ». Cet alignement est déterminant : il permet au moteur Power BI de lire les données directement depuis le stockage, sans couche coûteuse de décompression ou de traduction. Si vous visez une interactivité inférieure à la seconde, V-Order n'est pas optionnel : c'est le socle.
La performance a toujours un prix. Appliquer V-Order introduit un surcoût d'environ 15 % au moment de l'écriture, lors de l'ingestion. Vos pipelines tourneront un peu plus longtemps, mais les bénéfices en aval, sur des charges à forte lecture, sont spectaculaires. Dans la plupart des scénarios d'entreprise en 2026, accepter quelques minutes supplémentaires de traitement en phase ETL constitue un échange logique face à la réduction massive de latence et de consommation pendant les heures ouvrées.
Là où V-Order détermine l'encodage des données à l'intérieur d'un fichier, Z-Order détermine leur regroupement physique dans votre stockage. Cette technique de clustering multidimensionnel est votre meilleure défense face aux filtres complexes. Si vos utilisateurs filtrent fréquemment et simultanément par date, région et catégorie de produit, Z-Order garde ces points de données physiquement proches. L'efficacité du saut de fichiers s'en trouve nettement améliorée : le moteur ne touche que les données strictement nécessaires.
V-Order ou Z-Order : choisir le bon outil
Le choix n'est pas toujours exclusif : ces techniques résolvent des parties différentes du problème.
- V-Order (encodage) : idéal pour optimiser la structure interne des fichiers Parquet et accélérer la lecture par le moteur VertiPaq.
- Z-Order (clustering) : idéal pour réorganiser les données entre fichiers et maximiser l'efficacité du saut de fichiers fondé sur les filtres.
- L'approche hybride : sur vos tables de couche Or les plus critiques, appliquer les deux techniques offre le gain de performance ultime pour le mode Direct Lake de Power BI.
Activer V-Order dans vos sessions Spark
Vous pouvez activer V-Order au niveau de la session, via la configuration Spark, ou l'appliquer lors d'opérations d'écriture précises. Nous recommandons de concentrer ces efforts sur votre couche Or, où les données sont finalisées pour la restitution. Le suivi de l'impact sur vos points de terminaison SQL révélera une baisse immédiate de consommation. Si vous hésitez sur l'équilibre à trouver, notre équipe peut affiner votre stratégie de modernisation de l'architecture de données pour une efficacité maximale sur toutes les couches. Une application régulière via des pipelines automatisés garantit que vos performances restent stables et prévisibles à mesure que vos données grandissent.
Maintenance essentielle : compactage, VACUUM et vecteurs de suppression
La maintenance n'est pas un événement ponctuel : c'est un engagement continu envers la performance. V-Order et Z-Order définissent la structure des données, mais les commandes OPTIMIZE et VACUUM garantissent que cette structure reste efficace dans le temps. Pour optimiser vos tables Delta de lakehouse efficacement, intégrez ces tâches à vos routines post-ingestion. Cette démarche proactive prévient la dégradation des performances qui surprend souvent les équipes après quelques mois d'exploitation.
La commande OPTIMIZE réalise un « bin-packing » : elle fusionne les petits fichiers fragmentés créés par des flux fréquents en blocs plus grands et plus efficaces. Cette consolidation réduit la charge de métadonnées et accélère nettement la planification des requêtes. L'exécuter trop souvent gaspille toutefois des ressources de calcul. La bonne pratique en 2026 consiste à la déclencher après des changements de données importants ou pendant des fenêtres de faible trafic, pour un maximum d'efficacité sans dépense superflue.
Pour les tables souvent mises à jour, les vecteurs de suppression sont indispensables. Plutôt que de réécrire un fichier entier à chaque mise à jour ou suppression de ligne, Delta Lake crée un petit fichier « vecteur » qui marque le changement, ce qui réduit la latence en écriture. Avec le temps, ces vecteurs s'accumulent et finissent par ralentir les lectures. Lorsque vous optimisez vos tables Delta de lakehouse, votre stratégie doit prévoir une phase de consolidation où ces changements sont définitivement intégrés aux fichiers principaux, afin de préserver des lectures rapides.
Un flux de maintenance pas à pas
Une démarche structurée empêche la dette technique de s'accumuler. Nous recommandons ces étapes pour préserver la santé de votre Lakehouse :
- Évaluation : utilisez la commande Spark
DESCRIBE DETAILpour suivre le nombre de fichiers et la fragmentation de vos tables. - Compactage : exécutez
OPTIMIZEpour consolider les fichiers. Si la table est fortement filtrée, ajoutezZORDER BYsur des colonnes à forte cardinalité comme CustomerID ou TransactionDate. - Nettoyage : exécutez
VACUUMpour supprimer les fichiers dont le journal de transactions n'a plus besoin. Restez prudent : la rétention par défaut de 7 jours est généralement sûre, mais la réduire davantage peut casser les capacités de « voyage dans le temps ».
Gérer les vecteurs de suppression sur les tables à forte écriture
Dans une conception d'entrepôt de données moderne, nous rencontrons souvent des tables qui exigent des mises à jour quasi permanentes. Les vecteurs de suppression leur permettent de rester réactives pendant l'ingestion. Ce n'est toutefois pas une fonctionnalité que l'on active puis oublie : vous devez exécuter périodiquement un OPTIMIZE complet pour réintégrer ces vecteurs dans les fichiers de base. Vos tableaux de bord Power BI, très sollicités en lecture, ne paieront ainsi pas le prix de l'efficacité gagnée en écriture lors du chargement initial.
Orchestrer l'optimisation à l'échelle de l'entreprise
Lancer une commande de maintenance est simple ; piloter des centaines de tables dans un environnement d'entreprise demande une approche plus élaborée. Pour optimiser vos tables Delta de lakehouse à grande échelle, vous devez dépasser les scripts ponctuels et adopter une orchestration automatisée. En 2026, la complexité des patrimoines de données luxembourgeois impose que le réglage des performances devienne un processus d'arrière-plan plutôt qu'une corvée manuelle pour vos ingénieurs.
Microsoft Fabric offre deux voies principales d'orchestration. L'activité « Lakehouse Maintenance » de Fabric Data Factory propose une solution low-code pour des tâches standard comme le compactage et le nettoyage. Pour les équipes qui veulent plus de contrôle, les notebooks Spark autorisent une logique conditionnelle : vous pouvez écrire des scripts qui ne déclenchent OPTIMIZE que si une table dépasse un seuil de fichiers ou de fragmentation. Cette intelligence évite des dépenses de calcul inutiles tout en gardant vos tables les plus actives performantes. Centraliser ces journaux dans le hub de supervision Fabric permet à vos équipes de suivre la réussite des traitements et leur impact sur la capacité depuis un seul écran.
Construire le pipeline d'optimisation
Le calendrier fait tout en matière de gestion des ressources. Nous recommandons de planifier vos tâches de maintenance en dehors des heures de pointe, pour éviter la concurrence avec les actualisations Power BI du matin. La stratégie la plus efficace consiste à relier votre automatisation de pipelines directement à vos cycles d'ingestion. En déclenchant une optimisation ciblée juste après un chargement important, vous garantissez que les données sont « prêtes pour la restitution » avant la première connexion utilisateur. Une gestion d'erreurs robuste et des alertes automatiques sont indispensables : une tâche de maintenance échouée ne doit pas passer inaperçue jusqu'à ce qu'un tableau de bord ralentisse.
Gouvernance et modèles de responsabilité
Les outils techniques ne valent que par la gouvernance qui les entoure. Les organisations doivent définir clairement si la santé des tables relève de l'ingénierie des données ou des opérations de plateforme. Fixer des standards nationaux de fréquence de maintenance et de conventions de nommage garantit la cohérence à mesure que vous grandissez. Des revues architecturales Power BI régulières font le lien entre santé technique du stockage et expérience utilisateur. Elles confirment que vos efforts pour optimiser vos tables Delta de lakehouse produisent bien les gains de rapidité attendus par vos parties prenantes.
Si la gestion de ces couches d'orchestration pèse sur vos ressources internes, notre équipe peut prendre le relais. Découvrez nos services managés de capacité et d'optimisation pour garder un environnement Fabric sobre et réactif en permanence.
Conception orientée performance : l'architecture l'emporte sur le réglage ponctuel
Un réglage réactif revient à colmater une coque qui fuit en pleine mer : vous stoppez peut-être la voie d'eau, mais vous n'avez pas traité la faiblesse de la coque. Côté données, attendre qu'un tableau de bord ralentisse pour optimiser vos tables Delta de lakehouse est la recette de coûts élevés et d'une confiance utilisateur en berne. La vraie performance vient d'un socle architectural qui anticipe la croissance au lieu d'y réagir.
Nos services de migration Fabric reposent sur cette philosophie proactive. Plutôt que de traiter l'optimisation comme une tâche de nettoyage, nous l'inscrivons au cœur de la conception de votre Lakehouse. Chaque table est ainsi créée « performante », avec le bon partitionnement, l'encodage V-Order et les déclencheurs de maintenance déjà en place. Microsoft Solutions Partner certifié, nous regardons au-delà des commandes de base pour repérer les goulets d'étranglement cachés dans la gestion des métadonnées ou l'allocation de capacité, que le réglage ponctuel laisse souvent passer.
L'approche de Momentum One en ingénierie de la performance
En 2026, nous appliquons un cadre spécialisé, conçu pour le marché des entreprises luxembourgeoises. Il privilégie la scalabilité de long terme et la culture data interne. Le réglage technique ne représente que la moitié du chemin : vos équipes doivent aussi comprendre la logique de ces configurations. Nous comblons cet écart par une formation technique en entreprise qui permet à vos collaborateurs de maintenir les standards de performance que nous établissons. Ce double investissement, technologique et humain, transforme un « lac désordonné » en actif maîtrisé et à forte valeur.
Atteindre une stabilité durable
Une performance stable n'est pas une destination : c'est un état de supervision et d'affinage continus. Nos services managés jouent le rôle de filet de sécurité et garantissent que la croissance de vos volumes ne dégrade pas vos temps de réponse. Nous assurons une gestion permanente de la capacité pour garder vos coûts Fabric prévisibles et maîtrisés. Si vous êtes prêt à quitter la lutte réactive contre les incendies et à optimiser vos tables Delta de lakehouse pour l'avenir, contactez-nous pour une revue d'architecture de données sur mesure. Elle vous fournira une feuille de route claire pour moderniser votre environnement et sécuriser des performances optimales durablement.
Sécuriser l'avenir de vos données avec une architecture performante
Obtenir un environnement Microsoft Fabric performant demande plus que quelques commandes. Cela exige de passer d'un dépannage réactif à un état d'esprit centré sur l'architecture. En déployant des techniques comme V-Order et en automatisant vos cycles de maintenance essentiels, vous gardez une plateforme réactive à mesure que vos volumes augmentent. Lorsque vous optimisez vos tables Delta de lakehouse avec une vision stratégique, vous ne réparez pas seulement des rapports lents : vous bâtissez un socle évolutif pour toute l'organisation.
Microsoft Solutions Partner certifié doté d'une expertise approfondie de la modélisation de données à grande échelle, Momentum One est là pour vous aider à traverser cette complexité. Nous proposons des services décisionnels managés complets, qui gardent votre environnement sobre et efficace. Optimisez votre environnement Microsoft Fabric avec Momentum One dès aujourd'hui et mesurez la différence d'un patrimoine de données réellement moderne. Nous sommes prêts à vous accompagner vers des coûts prévisibles et des analyses extrêmement rapides.
Questions Fréquemment Posées
Quelle différence entre V-Order et Z-Order dans Microsoft Fabric ?
V-Order et Z-Order remplissent des rôles distincts dans la disposition de vos données. V-Order est un encodage propriétaire Microsoft qui optimise les fichiers Parquet pour le moteur VertiPaq, cœur du mode Direct Lake de Power BI. Le clustering Z-Order porte sur la localité physique des données entre plusieurs colonnes. Là où V-Order accélère la lecture de chaque fichier, Z-Order fait en sorte que le moteur ignore entièrement les fichiers non pertinents. Combiner les deux sur vos tables critiques de couche Or offre la meilleure performance possible.
À quelle fréquence exécuter la commande OPTIMIZE sur mes tables Delta ?
La fréquence d'exécution doit suivre vos schémas d'ingestion. Pour des tables alimentées en continu, une fenêtre de maintenance quotidienne évite généralement que le « problème des petits fichiers » dégrade les performances. Si vous traitez vos données par lots hebdomadaires, exécuter la commande juste après le chargement est plus efficace. Évitez de l'exécuter trop souvent sur de petites tables : le coût de calcul de la maintenance risquerait de dépasser l'économie réalisée sur les requêtes.
V-Order fonctionne-t-il avec des moteurs non Microsoft comme Databricks ?
V-Order produit des fichiers Parquet pleinement conformes aux standards open source. Des moteurs non Microsoft comme Databricks ou Spark peuvent donc les lire sans difficulté. Les bénéfices spécifiques de réorganisation et d'encodage de V-Order sont toutefois conçus pour être reconnus par les moteurs de calcul de Fabric. Vous ne perdez aucune compatibilité en l'utilisant, mais vous n'obtiendrez le gain de performance maximal qu'en interrogeant ces données au sein de l'écosystème Microsoft Fabric.
Puis-je utiliser VACUUM pour répondre à une demande d'effacement au titre du RGPD ?
VACUUM est un outil déterminant pour la conformité réglementaire, RGPD compris. Lorsque vous supprimez un enregistrement d'une table Delta, la donnée physique subsiste dans d'anciens fichiers Parquet afin de permettre le « voyage dans le temps ». VACUUM retire définitivement ces fichiers de votre stockage une fois la période de rétention dépassée. Pour des demandes strictes de droit à l'oubli, vous devrez peut-être ajuster vos paramètres de rétention afin que la suppression physique intervienne dans le délai légal.
Optimiser mes tables Delta réduira-t-il mes coûts de capacité Fabric ?
Les efforts pour optimiser vos tables Delta de lakehouse pèsent directement sur vos résultats. En réduisant le volume de données analysé et le nombre d'opérations d'entrée-sortie par requête, vous abaissez le total d'unités de capacité consommées. Cette efficacité est déterminante en 2026 pour les entreprises luxembourgeoises qui veulent développer leur analytique sans passer à un SKU Fabric plus coûteux. Des tables optimisées permettent à votre capacité actuelle de servir davantage d'utilisateurs simultanément.
Que sont les vecteurs de suppression et quand les activer ?
Les vecteurs de suppression sont une optimisation de stockage qui change la façon dont Delta Lake traite mises à jour et suppressions. Plutôt que de réécrire un fichier entier pour un seul changement, le moteur crée un petit fichier bitmap qui marque les lignes concernées. Activez-les sur vos tables à forte écriture pour accélérer vos opérations MERGE. Ils réduisent nettement la latence d'ingestion, mais vous devrez tout de même exécuter OPTIMIZE périodiquement pour réintégrer ces vecteurs dans les fichiers principaux.
Comment mesurer l'impact de mes travaux d'optimisation sur la performance ?
Vous pouvez suivre la réussite de chaque tâche via le hub de supervision Fabric, qui fournit des journaux détaillés. Pour mesurer l'impact réel, utilisez l'application Fabric Capacity Metrics et comparez la consommation d'unités de capacité avant et après avoir optimisé vos tables Delta de lakehouse. Pour des gains propres à un rapport, l'analyseur de performances Power BI montrera des temps d'attente « source de données » réduits. Cette approche fondée sur les données vous permet de démontrer le ROI de vos efforts à vos parties prenantes.
Y a-t-il un risque de perte de données lors de la maintenance des tables Delta ?
Les opérations de maintenance dans Delta Lake sont sûres par nature, car pleinement conformes aux propriétés ACID. Le journal de transactions garantit qu'une table ne reste jamais dans un état corrompu, même si un traitement est interrompu. Le seul risque opérationnel concerne la commande VACUUM : une période de rétention trop courte vous privera de la possibilité d'interroger d'anciennes versions de vos données. Vos données actives restent en revanche protégées tout au long de la maintenance.