Comment créer et exécuter des pipelines ETL performants dans Databricks
Découvrez comment créer et exécuter efficacement des pipelines ETL dans Databricks. Maîtrisez l'architecture Medallion pour réduire les erreurs et fournir des données fiables à vos analyses.
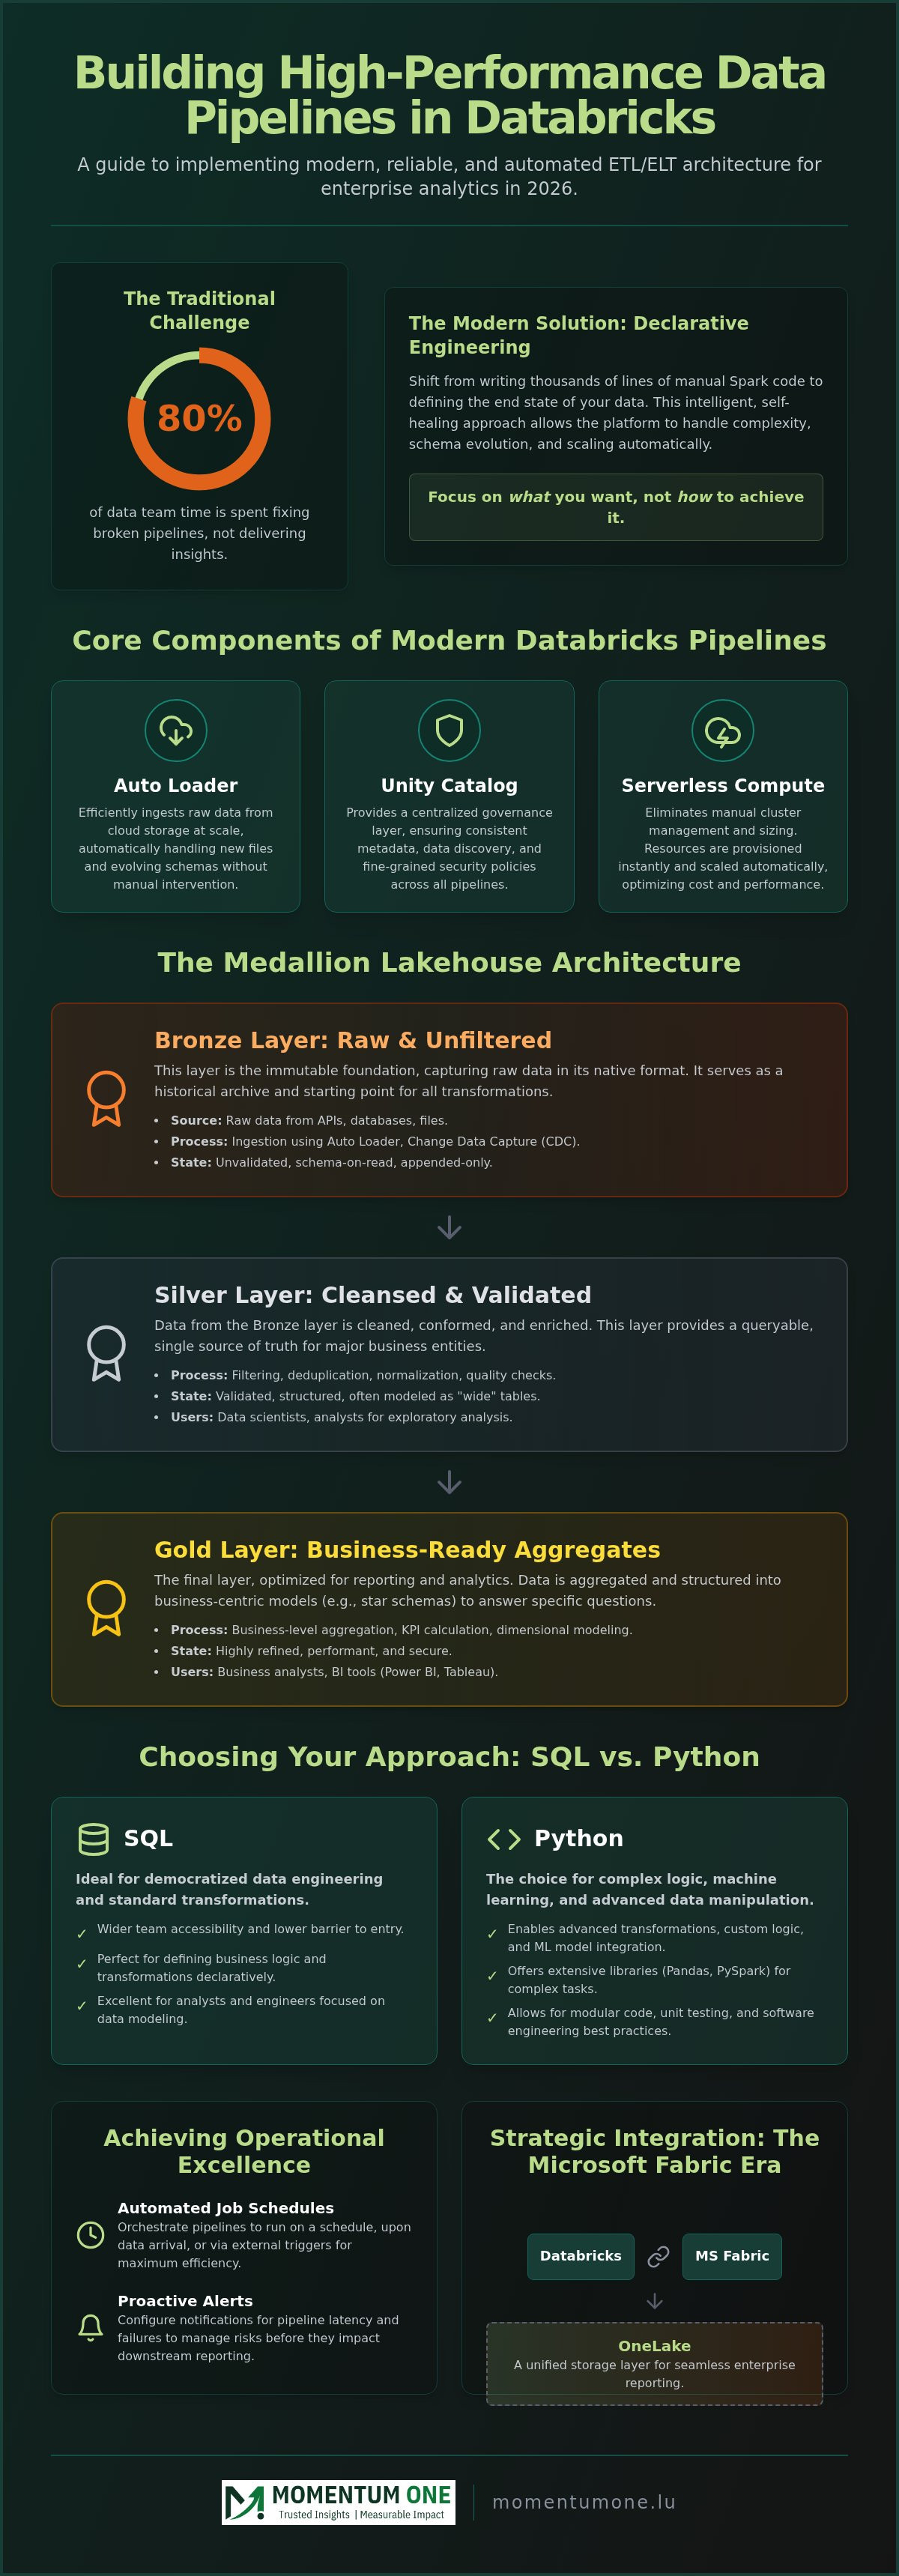
- Comprenez comment le cadre Medallion Lakehouse organise les données en couches Bronze, Silver et Gold pour garantir qualité et gouvernance.
- Apprenez les techniques modernes pour créer et exécuter des pipelines ETL dans Databricks en passant des scripts Spark manuels à des architectures déclaratives et intelligentes.
- Déterminez l'approche la plus adaptée à votre équipe en comparant SQL, qui démocratise l'ingénierie des données, et Python, taillé pour les traitements complexes de machine learning.
- Atteignez l'excellence opérationnelle en automatisant la planification des jobs et en configurant des alertes proactives sur la latence et les risques d'échec des pipelines.
- Explorez la synergie stratégique entre Databricks et Microsoft Fabric, avec OneLake comme couche de stockage unifiée pour le reporting d'entreprise.
Pourquoi la plupart des équipes data passent-elles 80 % de leur temps à réparer une logique d'ingestion défaillante plutôt qu'à livrer les analyses que leurs parties prenantes attendent vraiment ? C'est une réalité frustrante lorsque l'on gère la complexité du batch et du streaming, avec, à la clé, des problèmes de qualité qui fragilisent l'ensemble de votre reporting. Nous savons qu'une charge opérationnelle élevée peut faire de votre environnement de données un fardeau plutôt qu'un atout. Ce guide entend inverser cette tendance en vous montrant comment créer et exécuter des pipelines ETL dans Databricks avec précision et fiabilité.
Vous maîtriserez l'architecture et l'exécution de pipelines de données performants, conçus pour alimenter une analytique d'entreprise exigeante. Nous vous proposons une feuille de route claire pour mettre en œuvre l'architecture Medallion et réduire les interventions manuelles grâce à une orchestration aboutie. À la fin de cet article, vous saurez comment assurer un flux de données fluide vers Power BI et transformer votre environnement Databricks en un moteur fiable de croissance en 2026. Nous passerons en revue les prérequis techniques des derniers runtimes et verrons comment maintenir des performances optimales sans dépannage manuel permanent.
Comprendre l'écosystème ETL de Databricks en 2026
L'approche traditionnelle de l' extraction, transformation, chargement (ETL) a connu une transformation radicale. En 2026, nous avons abandonné l'écriture laborieuse de milliers de lignes de code Spark manuel. L'écosystème a évolué vers un processus déclaratif et intelligent, où la plateforme comprend elle-même l'intention de vos mouvements de données. Aujourd'hui, lorsque vous créez et exécutez des pipelines ETL dans Databricks, vous ne déplacez pas seulement des données : vous orchestrez un environnement auto-réparateur qui s'adapte aux évolutions de schéma et aux variations de volume sans intervention humaine constante.
Ce basculement est particulièrement visible dans le passage aux Spark Declarative Pipelines, anciennement Delta Live Tables (DLT). Ce cadre permet aux ingénieurs data de se concentrer sur la définition de l'état final de leurs données. Pour les organisations luxembourgeoises qui traitent de gros volumes, Databricks s'est imposé comme le moteur de référence, car il absorbe automatiquement la complexité du calcul distribué. Cette simplicité doit beaucoup à Lakeflow, qui fluidifie tout le cycle de vie, de l'ingestion brute à la livraison finale, en jouant le rôle d'orchestrateur unifié du lakehouse moderne.
Les composants clés des pipelines Databricks modernes
Trois composants sont indispensables pour atteindre un haut niveau de performance. Auto Loader constitue votre première ligne de défense : il ingère efficacement les données brutes du stockage cloud à grande échelle tout en gérant l'évolution des schémas. Pour garder le contrôle, Unity Catalog apporte une couche de gouvernance centralisée qui garantit la cohérence des métadonnées et des politiques de sécurité sur l'ensemble des pipelines. Enfin, le calcul serverless a révolutionné la gestion de l'infrastructure. Il supprime le dimensionnement manuel des clusters et permet à vos équipes de se consacrer à l' automatisation des pipelines et des dataflows plutôt qu'à la maintenance du matériel.
Les arguments métier de l'ingénierie de données déclarative
Adopter une approche déclarative n'est pas qu'une amélioration technique : c'est une décision stratégique. En automatisant la gestion des dépendances, les entreprises réduisent nettement leur délai d'accès à l'information et livrent les données critiques plus vite que jamais. La fiabilité constitue l'autre pilier : les attentes de qualité intégrées garantissent que seules des données propres et vérifiées atteignent vos applications en aval. Sur le plan financier, ces optimisations abaissent le coût total de possession (TCO) en assurant une utilisation maximale des ressources de calcul et en évitant le gaspillage lié aux clusters inactifs qui pénalisait les premiers projets data dans le cloud.
Concevoir pour réussir : le cadre Medallion Lakehouse
La réussite en ingénierie de données moderne repose sur une approche structurée de la qualité et de la circulation des données. L'architecture Medallion en est le standard : elle organise les données en couches Bronze, Silver et Gold. Ce cadre fait partie intégrante de la conception Lakehouse, qui remplace efficacement les entrepôts de données traditionnels et cloisonnés en combinant le faible coût des data lakes et les performances des bases relationnelles. Lorsque vous choisissez votre architecture en 2026, adopter un modèle Lakehouse permet de garder la modélisation dimensionnelle au cœur de votre stratégie, sans le poids des infrastructures héritées. Pour créer et exécuter efficacement des pipelines ETL dans Databricks, votre équipe doit considérer ces étapes architecturales comme des jalons incontournables de maturité des données.
Couche Bronze : ingestion brute et CDC
Le parcours commence par la couche Bronze, où les données brutes sont captées dans leur format natif. Cette couche constitue un socle immuable qui garantit de ne jamais perdre le contexte d'origine des sources. Pour beaucoup d'entreprises, la capture des changements (CDC) depuis les bases transactionnelles à l'aide d'outils comme Debezium est une priorité. Elle permet une synchronisation en temps réel sans surcharger les systèmes sources. Avec Lakeflow Connect, la gestion de l'évolution des schémas devient automatique et évite les ruptures de pipeline lorsque les tables sources changent. C'est précisément cette fiabilité qui pousse de nombreuses organisations à faire appel à une expertise en conception d'entrepôt de données et de lakehouse afin d'assurer des fondations évolutives dès le premier jour.
Couche Silver : nettoyage et validation
Une fois les données ingérées, la couche Silver se concentre sur la normalisation et la qualité. Nous y appliquons des « attentes » pour écarter les enregistrements corrompus et supprimer les doublons. Ce processus rejoint la documentation Microsoft sur l'ETL, qui souligne la nécessité d'un état intermédiaire propre avant l'application de la logique métier. En établissant une source unique de vérité à ce stade, vous garantissez que chaque rapport en aval s'appuie sur des données vérifiées et cohérentes. Il s'agit de transformer un bruit brut en un actif fiable auquel vos analystes peuvent se fier.
Couche Gold : agrégation et logique métier
C'est dans la couche Gold que la donnée devient actionnable. Cette étape est dédiée au reporting haute performance : vues matérialisées et règles métier complexes y calculent des indicateurs précis. Nous optimisons ces jeux de données pour une intégration fluide avec Power BI, afin que l'utilisateur final bénéficie de temps de réponse très courts. Arrivées dans la couche Gold, les données sont pleinement raffinées et prêtes à alimenter une analytique d'entreprise exigeante. Cette progression méthodique garantit que vos pipelines ne se contentent pas de déplacer des données : ils délivrent de la valeur stratégique à chaque étape du cycle de vie.
Créer et exécuter des pipelines : approches SQL et Python
Le choix du langage de développement est déterminant pour toute équipe data. En 2026, nous observons une véritable démocratisation de l'ingénierie des données, où SQL est devenu le langage principal de nombreux projets d'entreprise. Ce changement permet à un plus grand nombre d'analystes de contribuer directement aux environnements de production. Le choix n'est toutefois pas binaire. Pour créer et exécuter avec succès des pipelines ETL dans Databricks, les architectes doivent équilibrer la simplicité de SQL et la grande souplesse de Python, en particulier lorsqu'il s'agit d'intégrer du machine learning ou des transformations complexes.
Développer en SQL dans Databricks
SQL ne sert plus seulement à interroger : c'est un outil puissant pour construire des structures de données robustes. Grâce au langage de définition de données (DDL), les équipes déclarent tables et vues avec la même syntaxe que sur une base relationnelle classique. Cette approche simplifie les jointures complexes et les fonctions de fenêtrage, et rend la logique lisible pour les parties prenantes. Pour les équipes qui souhaitent monter en compétences, nos formations entreprise au data fabric comblent l'écart entre le requêtage de base et le développement avancé de pipelines. Les bonnes pratiques mettent aujourd'hui l'accent sur la modularité. Parmi les stratégies clés :
- découper la logique en petites vues testables ;
- utiliser des alias explicites pour les calculs complexes ;
- documenter la logique métier directement dans les scripts SQL.
Transformations avancées en Python
Python reste la référence lorsque votre logique dépasse les capacités du SQL standard. Avec PySpark, les ingénieurs créent des transformations sur mesure qui gèrent des structures de données non linéaires ou des formats de fichiers spécifiques. C'est particulièrement précieux pour les organisations luxembourgeoises qui intègrent des bibliothèques tierces pour du traitement spécialisé ou des modèles de machine learning avancés. Au-delà de l'écriture de code, Python permet des tests unitaires rigoureux et un débogage fin. Ce niveau de contrôle rend votre logique de pipeline résiliente et capable de traiter des cas limites qui mettraient en défaut des workflows purement SQL.
Industrialiser les pipelines déclaratifs
Passer du notebook à un système de production demande de la rigueur. Les environnements Databricks modernes s'appuient sur l'intégration Git pour gérer les versions et les déploiements de pipelines, afin que chaque modification soit tracée et réversible. Nous pouvons désormais automatiser les redémarrages et la gestion des erreurs, ce qui réduit fortement les interventions manuelles pendant le cycle « extraction, transformation, chargement ». Les Spark Declarative Pipelines constituent le pont entre développement et production. Que vous exécutiez des traitements par lots pour les rapports nocturnes ou du streaming temps réel pour des analyses immédiates, ces cadres déclaratifs garantissent un mode d'exécution optimisé à la fois pour la performance et pour le coût.
Excellence opérationnelle : supervision et automatisation des jobs
Construire un environnement de données performant ne représente que la moitié du chemin. Pour créer et exécuter des pipelines ETL dans Databricks qui passent réellement à l'échelle, votre équipe doit se tourner vers la santé opérationnelle sur le long terme. Cela suppose de dépasser l'exécution manuelle et d'adopter une feuille de route d'automatisation en quatre étapes. Premièrement, définissez la planification et les déclencheurs de vos jobs directement dans l'interface Databricks pour garantir des traitements réguliers. Deuxièmement, configurez des alertes fines sur les échecs de pipeline ou les pics de latence, afin de réagir avant que les parties prenantes ne constatent un retard. Troisièmement, utilisez Unity Catalog pour suivre les indicateurs de qualité des données en temps réel. Enfin, mettez en place des contrôles de coûts stricts et des alertes budgétaires sur les ressources de calcul pour éviter toute dépense cloud imprévue. Cette approche globale est essentielle, et de nombreuses organisations estiment que nos services managés Power BI sont déterminants pour préserver la santé de bout en bout de l'environnement.
Supervision de la qualité des données et attentes
La qualité des données est une exigence de gouvernance incontournable en 2026. Dans vos pipelines déclaratifs, vous pouvez définir des « attentes » qui déclenchent des actions « FAIL », « DROP » ou « WARN » selon la gravité du problème constaté. Une clé primaire manquante peut par exemple déclencher un « FAIL » qui arrête le pipeline, tandis qu'une erreur de format se traduira simplement par un « DROP » de l'enregistrement. Le tableau de bord Databricks vous permet de visualiser cet état de santé et d'avoir une vue claire de l'intégrité de vos données. Pour les entreprises établies au Luxembourg, des audits réguliers garantissent la conformité aux normes nationales et aux protocoles de sécurité internes. Ce niveau de supervision est plus simple à tenir avec des services d'incident et de support dédiés qui assurent la continuité de vos opérations.
Réglage des performances et optimisation des coûts
L'efficacité pèse directement sur vos résultats. Optimiser la taille des fichiers et les stratégies de partitionnement des tables Delta est une étape fondamentale pour réduire la latence des requêtes. Le moteur Photon vous permet d'accélérer l'exécution, même pour les logiques de transformation les plus complexes. Nous recommandons d'identifier et de traiter les goulets d'étranglement au plus tôt en analysant les métriques de l'interface Spark et les plans d'exécution. Ce réglage proactif garantit une utilisation efficace de vos ressources de calcul, maintient un coût total de possession bas et délivre les analyses rapides dont votre activité a besoin. Lorsque vous créez et exécutez des pipelines ETL dans Databricks, ces gains de performance se traduisent par un reporting plus réactif et une équipe data plus agile.
Intégration stratégique : Databricks à l'ère de Microsoft Fabric
La synergie entre Databricks et Microsoft Fabric marque une évolution majeure des stratégies data en entreprise en 2026. Là où certains voyaient des plateformes concurrentes, les équipes data performantes constatent une collaboration puissante. OneLake sert de couche de stockage unifiée : Databricks y écrit des tables Delta ouvertes auxquelles Fabric accède instantanément via des raccourcis. Les déplacements de données coûteux et redondants disparaissent. Lorsque vous créez et exécutez des pipelines ETL dans Databricks, vous alimentez en réalité le moteur haute performance de votre Lakehouse Fabric. Chez Momentum One, nous sommes spécialisés dans cette harmonie entre plateformes et vous accompagnons dans les complexités des services de migration vers Microsoft Fabric afin que votre architecture reste pérenne.
Connecter Databricks à Power BI
Livrer des analyses aux parties prenantes suppose une connexion solide entre vos données traitées et votre couche de reporting. Pour les tableaux de bord de direction qui exigent des mises à jour en temps réel, DirectQuery offre un lien direct vers vos tables Databricks. En revanche, pour l'expérience la plus rapide sur des rapports complexes, le mode Import reste un choix pertinent. Nous recommandons une approche hybride afin d'équilibrer latence et performance. Pour tirer le meilleur parti de la vitesse de vos rapports, il est souvent nécessaire de faire appel à des experts en optimisation DAX capables d'affiner vos mesures et de faire évoluer votre environnement Power BI au rythme de la croissance de vos données. Le travail réalisé dans vos pipelines se traduit ainsi par une expérience fluide et réactive pour chaque utilisateur.
Services managés pour la stack data moderne
Construire un environnement de données abouti est un jalon, mais en maintenir la performance demande un engagement continu. Nous constatons que les organisations luxembourgeoises les plus performantes passent d'une logique de projet à une gouvernance managée récurrente. Ce changement garantit que vos pipelines ne deviennent pas un goulet d'étranglement à mesure que vos volumes augmentent. Momentum One apporte la maîtrise nécessaire à la gestion de ces environnements complexes, avec un accompagnement proactif qui prévient les incidents avant qu'ils n'affectent votre activité. En vous appuyant sur nos services d'automatisation des pipelines et des dataflows, vous réduisez la charge manuelle et recentrez vos équipes internes sur les initiatives stratégiques. Nous jouons le rôle de stratège fiable pour que chaque étape de création et d'exécution de vos pipelines ETL dans Databricks contribue à la justesse des données et à la croissance de votre organisation.
Préparer votre architecture de données pour l'avenir en 2026
Bâtir un environnement de données performant ne consiste pas seulement à déplacer des octets : il s'agit d'installer un cadre qui soutient des objectifs d'entreprise de long terme. Nous avons vu comment l'architecture Medallion garantit la qualité des données, tandis que le choix entre SQL et Python permet à votre équipe d'équilibrer simplicité et logique complexe. En intégrant ces processus à Microsoft Fabric et Power BI, vos efforts techniques se transforment directement en valeur métier. Lorsque vous créez et exécutez des pipelines ETL dans Databricks avec ce niveau de pilotage stratégique, vous supprimez la charge opérationnelle et obtenez de meilleures analyses.
Partenaire Microsoft certifié, nous mettons des années d'expertise en intégration Databricks et Fabric au service de votre montée en puissance. Nos services managés sur mesure sont pensés pour l'évolutivité et la santé de votre environnement sur la durée, afin que vos données restent un actif fiable. Automatisez vos pipelines de données avec Momentum One dès aujourd'hui et préservez votre avantage concurrentiel. Votre trajectoire vers un avenir data plus efficace et automatisé commence maintenant.
Questions Fréquemment Posées
Quelle est la différence entre ETL et ELT dans un environnement Databricks ?
L'ETL transforme les données avant qu'elles n'atteignent la cible, tandis que l'ELT charge d'abord les données brutes et exécute les transformations directement sur la puissance de calcul du lakehouse. Databricks privilégie l'approche ELT, car elle permet de conserver les jeux de données d'origine dans la couche Bronze. Vous gardez ainsi la souplesse de retraiter l'information à mesure que la logique métier évolue, sans devoir réextraire les données des systèmes sources.
Combien coûte l'exécution de pipelines de données dans Databricks en 2026 ?
Databricks applique un modèle de paiement à l'usage fondé sur les Databricks Units (DBU), avec des tarifs débutant à 0,15 $ par DBU pour l'ingénierie des données et 0,22 $ par DBU pour l'entreposage. Ces coûts sont facturés à la seconde de traitement. S'y ajoutent les frais d'infrastructure et de stockage de votre fournisseur cloud. Piloter efficacement ces variables constitue un volet central de nos services managés, gage d'efficacité sur la durée.
Puis-je construire des pipelines Databricks uniquement en SQL ?
Oui, vous pouvez créer et exécuter des pipelines ETL dans Databricks uniquement en SQL. Databricks SQL et les Spark Declarative Pipelines permettent aux analystes de définir des tables, des vues et des attentes de qualité de données à l'aide des commandes DDL et DML habituelles. Cette démocratisation de l'ingénierie des données signifie que votre équipe n'a pas besoin de maîtriser Python pour créer des pipelines robustes, prêts pour la production, capables de gérer sans peine des charges de travail d'entreprise complexes.
Qu'est-ce que l'architecture Medallion et pourquoi est-elle recommandée pour Databricks ?
L'architecture Medallion organise les données en trois couches logiques : Bronze pour l'ingestion brute, Silver pour les données nettoyées et Gold pour les agrégats prêts pour le métier. Elle est recommandée parce qu'elle offre une trajectoire structurée vers la qualité et la maturité des données. En séparant les données brutes des analyses affinées, les équipes garantissent une source unique de vérité et un reporting performant, tout en conservant la capacité d'auditer la lignée des données à chaque étape.
Comment Databricks s'intègre-t-il à Microsoft Fabric et à OneLake ?
L'intégration passe par les raccourcis OneLake, qui permettent à Microsoft Fabric d'accéder aux tables Delta de Databricks sans déplacer ni copier les données. Cette synergie vous laisse utiliser Databricks comme moteur d'ingénierie haute performance tout en exploitant Fabric pour une BI et un reporting unifiés. C'est une approche stratégique qui combine le meilleur des deux mondes et offre une expérience fluide aux ingénieurs data comme aux analystes métier.
Databricks convient-il aux pipelines de données en streaming temps réel ?
Databricks est particulièrement adapté au temps réel grâce à Spark Structured Streaming. Ce cadre traite les flux comme une table continue, ce qui simplifie la création et l'exécution de pipelines ETL dans Databricks gérant à la fois le batch et le temps réel. Des fonctionnalités comme Auto Loader et les déclencheurs à faible latence garantissent que vos tableaux de bord reflètent l'information la plus récente, sans la complexité d'architectures de streaming séparées.
Quelles sont les bonnes pratiques de sécurité pour les pipelines Databricks au Luxembourg ?
La sécurité commence avec Unity Catalog, pour un contrôle d'accès centralisé et un suivi de la lignée des données sur tous les espaces de travail. Au Luxembourg, les entreprises doivent accorder la priorité à la localisation des données et vérifier que le chiffrement est actif au repos comme en transit. La mise en place d'autorisations granulaires garantit que seuls les utilisateurs habilités accèdent aux jeux de données sensibles. Des audits réguliers et une supervision automatisée via nos services managés aident à maintenir une conformité stricte aux normes nationales et aux protocoles internes.
Comment surveiller les performances et le coût de mes jobs Databricks ?
Utilisez l'interface Jobs de Databricks et l'interface Spark pour repérer les goulets d'étranglement et suivre les plans d'exécution en temps réel. Côté coûts, Unity Catalog met à disposition des tables système qui consignent la consommation de DBU et l'usage du calcul. Configurer des alertes budgétaires et recourir au calcul serverless aide à éviter les envolées de coûts inattendues. Une supervision proactive garantit des pipelines efficaces et économiques à mesure que vos volumes de données augmentent.