Comment construire et valider des pipelines automatisés de données Fabric
Construisez une automatisation fiable des pipelines de données Fabric avec un mouvement intelligent des données, des contrôles qualité, des flux de travail Git et des tests qui détectent les problèmes tôt, avant la production.
- Choisissez des activités de copie, du miroir ou des raccourcis OneLake en fonction de la manière dont les données doivent se déplacer et si elles doivent être copiées ou consultées sur place.
- Des portes de qualité de construction qui valident les fichiers entrants et les données transformées, puis exécutez des tests dans un espace de travail de développement ou d’étape avant la production.
- Utilisez des activités de pipeline modulaires, des plannings ou déclencheurs d’événements appropriés, ainsi que l’intégration Git pour faciliter la gestion et le déploiement des workflows.
- Planifiez les migrations autour des dépendances d’artefacts et des références d’espaces de travail, et validez les pipelines promus avant de vous y appuyer en production.
- Utilisez la surveillance exécutive, les politiques de réessayage, les journaux et les alertes pour détecter les défaillances, comprendre leurs causes et répondre sans relancer plus de flux que nécessaire.
Un seul planning ne rendra pas un pipeline Fabric fiable. Une automatisation efficace des pipelines de données Fabric combine la bonne approche de déplacement des données avec des activités modulaires, des contrôles qualité et des tests de déploiement avant la production. Exécutez les pipelines selon un planning ou en réponse à un événement, puis validez les fichiers entrants et les données qu’ils produisent.
Il est facile de se concentrer sur le transfert des données d’un endroit à un autre. La partie la plus difficile est de s’assurer que chaque étape s’exécute dans le bon ordre, détecte les problèmes tôt et reste maintenable au fur et à mesure que votre environnement Fabric évolue.
Ce guide explique comment construire et planifier des pipelines, choisir entre les activités de copie, le miroirement et les raccourcis OneLake, et ajouter une validation qui vérifie plus que le succès d’une exécution. Vous apprendrez également à connecter les espaces de travail avec Git, tester les modifications avant le déploiement et planifier une migration Fabric autour d’un comportement fiable du pipeline. L’objectif est un flux de travail pratique qui clarifie le mouvement des données et aide à faire émerger les problèmes avant qu’ils n’atteignent la production.
Choisir entre des tâches de copiage, des activités de copie, le miroir, et les raccourcis OneLake
- Choisissez un motif de déplacement des données en fonction de si la destination a besoin de sa propre copie des données. Utilisez une activité de copie lorsqu’un pipeline doit déplacer des fichiers ou des lignes dans le cadre d’un flux de travail plus large. Un travail de copie convient à une tâche de transfert définie qui s’exécute indépendamment. Le miroir conserve une source prise en charge représentée dans Fabric, tandis qu’un raccourci OneLake permet d’accéder aux données sans les copier ailleurs.
Par exemple, utilisez un raccourci lorsqu’un Lakehouse doit référencer des données OneLake existantes. Choisissez de copier lorsqu’une table de destination nécessite un résultat séparé et préparé. Considérez le miroir comme une option de réplication, et non comme un remplacement des règles de transformation.
- Associez l’élément au travail après le mouvement. Dataflows Gen2 utilise Power Query pour connecter, nettoyer et transformer les données avant de les stocker dans OneLake. Ils peuvent écrire des données propres sous forme de tables Delta. Les pipelines orchestrent ces étapes en parallèle des notebooks, entrepôts et actualisations de jeux de données Power BI.
Un pipeline peut copier des fichiers texte délimités d’un dossier Lakehouse Files dans une table Lakehouse. Pour un exemple de CSV, mappe
dateversDateettotalversSalesValue, puis écrivez dansSalesTable. Spécifiez explicitement le dossier source et la table de destination. - Paramètres de test et propriétés d’activité avant le déploiement. Définissez une valeur de développement pour chaque chemin, nom de table ou plage de dates, puis exécutez le pipeline avec des entrées représentatives. Confirmez que l’activité utilise la source, la destination, le format et le mappage de colonnes prévus. Testez à la fois une entrée valide et une valeur invalide, afin qu’une exécution ratée montre quel paramètre nécessite une attention.
Concentrez chaque activité sur une seule opération. Commandez les activités dépendantes afin que l’étape suivante ne commence qu’après la réussite de son prédécesseur. Cela facilite la réévaluation d’une étape spécifique au lieu de répéter tout le flux de travail.
- Réglez les déclencheurs pour correspondre au moment où les données deviennent utilisables. Les pipelines Fabric peuvent s’exécuter manuellement, selon un planning, ou après un événement tel qu’un nouveau fichier OneLake. Activator peut lancer un pipeline après un événement OneLake
FileCreatedconfiguré. Utilisez un planning pour des lots prévisibles et un déclencheur d’événement lorsqu’un fichier arrive devrait inciter un traitement immédiat.Avant de copier, ajoutez une activité de validation pour vérifier le dossier source. Il peut confirmer qu’au moins un fichier est présent ou vérifier une taille minimale d’octet. Ces vérifications détectent les arrivées vides avant que les transformations en aval ne commencent.
- Incluez la tarification par unité de capacité dans les revues de conception sans supposer qu’une méthode de déplacement coûte toujours moins cher. Comparez la consommation de capacité mesurée selon la fréquence d’exécution réaliste, le volume de données et les schémas d’activité simultanés. Enregistrez ces mesures en même temps que les exigences de rafraîchissement avant de choisir une approche de déploiement. La demande de capacité dépend du comportement de la charge de travail, donc une copie de fichier à basse fréquence et un flux de travail de transformation fréquent nécessitent des évaluations différentes.
Pour les équipes luxembourgeoises qui planifient le pipeline et le travail de flux de données, le service d’automatisation du pipeline et du flux de données relie les choix de mouvement aux exigences opérationnelles. Documentez ensemble le format sélectionné, le déclencheur, la règle de validation et le chemin de défaillance.
Essais de niveau et portes de qualité
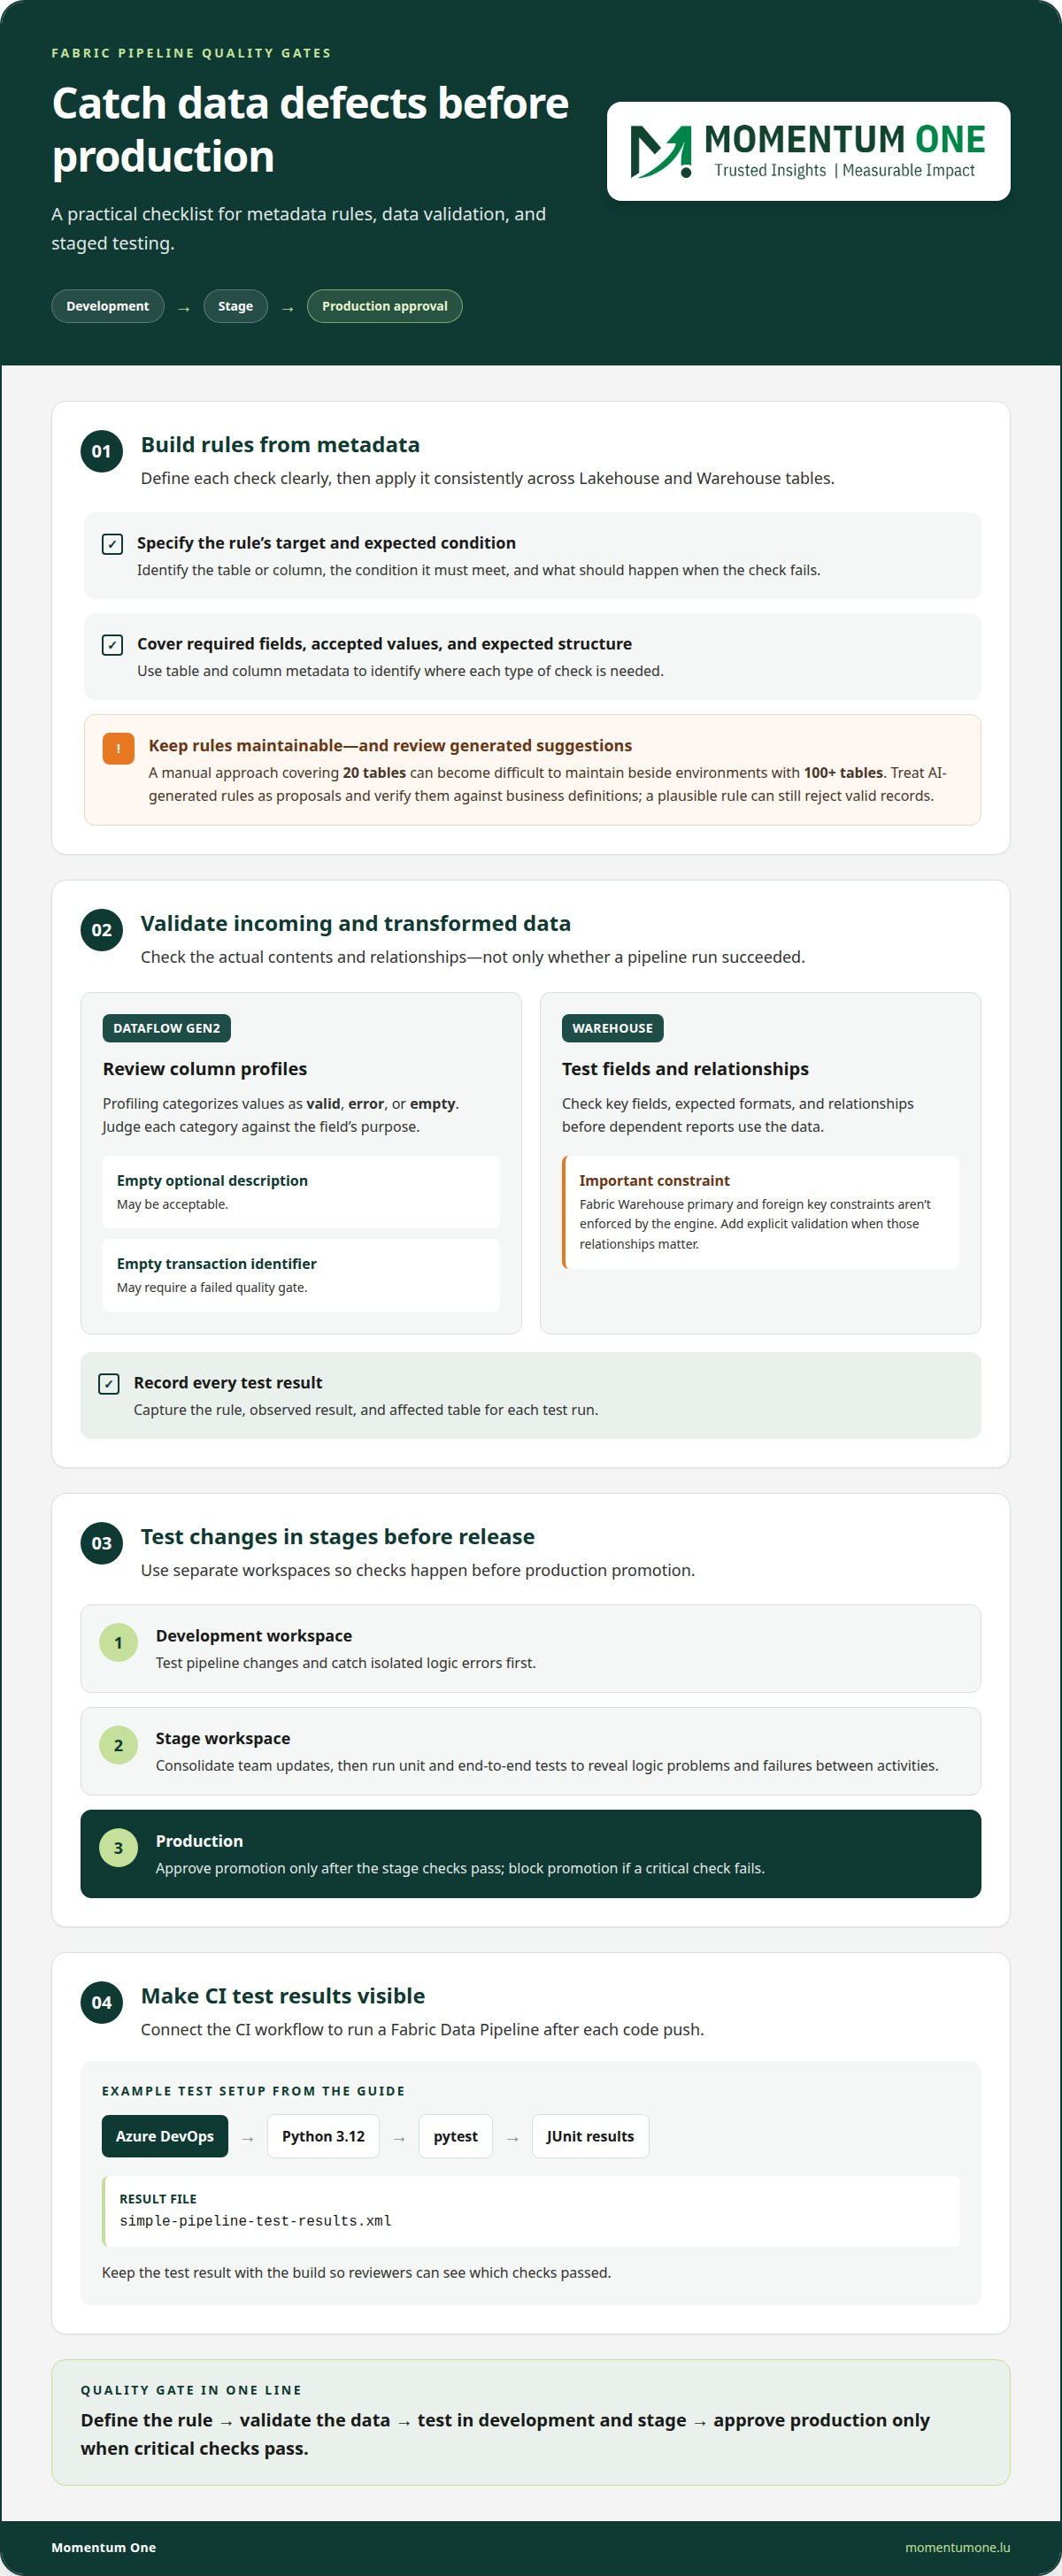
Utilisez des espaces de travail de développement, d’étape et de production séparés pour détecter les défauts de données avant la publication. Faites en sorte que chaque test de porte soit une règle spécifique, enregistrez le résultat, et bloquez la promotion si un contrôle critique échoue.
-
Appliquer des contrôles de qualité basés sur les métadonnées
Construisez les règles de qualité à partir des métadonnées de tables et de colonnes, puis appliquez-les de manière cohérente à travers les tables Lakehouse et Warehouse. Définissez la cible de chaque règle, la condition attendue et la réponse aux pannes afin que les relecteurs puissent voir ce qu’elle protège. Une approche manuelle couvrant 20 tables peut devenir difficile à maintenir à côté d’environnements à 100+ tableaux.
Utilisez des métadonnées pour identifier les tables qui nécessitent des vérifications des champs requis, des valeurs acceptées ou de la structure attendue. Les règles générées par IA peuvent aider à rédiger des candidats à partir de descriptions et de schémas, mais traitez chaque suggestion comme une proposition. Validez sa signification par rapport aux définitions métier avant de l’ajouter à un espace de travail de stage : une règle plausible peut toujours rejeter des enregistrements valides.
-
Valider la qualité des données
Effectuez des vérifications à la fois sur les données entrantes et les sorties transformées. Dans Dataflow Gen2, le profilage de colonnes catégorise les valeurs comme valides, d’erreur ou vides. Examinez ces catégories selon l’objectif du champ : une description optionnelle vide peut être acceptable, tandis qu’un identifiant de transaction vide peut nécessiter une porte de qualité défaillante.
Pour une table Warehouse, les champs de clé de test, les formats attendus et les relations avant que les rapports dépendants n’utilisent les données. Les contraintes de clé primaire et étrangère de Fabric Warehouse ne sont pas imposées par le moteur, donc ajoutez une validation explicite lorsque ces relations comptent. Notez la règle, le résultat observé et la table affectée pour chaque exécution de test.
- Séparer les contrôles de développement de l’approbation de la version. Tester d’abord les changements de pipeline dans un espace de travail de développement, puis consolider les mises à jour de l’équipe dans un espace de travail d’étape. Y effectuer des tests unitaires et de bout en bout avant d’approuver la production. Cette séquence peut révéler à la fois des erreurs logiques isolées et des défaillances qui n’apparaissent que lorsque les activités du pipeline fonctionnent ensemble.
Connectez le flux de travail CI pour exécuter un pipeline de données Fabric après chaque poussée de code. Dans un exemple Azure DevOps, Python 3.12 exécute des tests avec pytest et écrit la sortie JUnit sur
simple-pipeline-test-results.xml. Conservez ce résultat avec la compilation afin que les évaluateurs puissent voir quelles vérifications ont été réussies. - Faire échouer les tests pour des raisons significatives. Par exemple, une assertion s’attendant à ce qu’un répertoire nommé
SampleDataéchoue si le nom attendu change enSampleData2. Cette défaillance montre que la porte de libération détecte une hypothèse brisée au lieu de simplement confirmer qu’un pipeline a commencé.Utilisez les résultats visuels des tests pour retracer les erreurs jusqu’à la table, la règle ou l’activité concernée. Si les portes de qualité doivent s’aligner entre un Lakehouse et un Entrepôt, discutez d’une approche de qualité des données fondée sur vos besoins de modèle et de rapports.
Construire et planifier des pipelines de données Fabric
Construis des flux de travail comme des séquences claires, puis connecte chaque exécution au bon environnement. Stocke les définitions de planning avec des modifications de pipeline pour garder les déploiements gérables.
-
Flux de travail de construction de pipeline
Organisez chaque pipeline Fabric autour d’un résultat défini, comme charger des données avant de rafraîchir un modèle sémantique Power BI. Ajouter des flux Dataflows Gen2 pour la transformation, des notebooks pour le traitement et des activités d’entrepôt lorsque le flux de travail les exige. Gardez les activités modulaires, afin qu’une étape ratée puisse être retentée sans relancer chaque opération terminée.
Définir des dépendances pour que chaque activité ne commence qu’après la réussite de son prédécesseur requis. Par exemple, chargez une table Lakehouse avant de lancer son contrôle qualité, puis rafraîchissez Power BI seulement après validation passée. Cette séquence rend la porte de qualité des données visible et empêche que les étapes en aval ne consomment des sorties incomplètes.
-
Surveillance et journalisation des paramètres
Examinez le statut de chaque exécution de pipeline et les résultats d’activité dans l’espace de travail Fabric. Utilisez la séquence d’activité pour trouver où un flux de travail s’est arrêté, puis comparez les entrées de l’étape ratée avec sa source, sa destination et sa transformation configurées. Gardez suffisamment de contexte opérationnel pour distinguer un problème de source d’un échec de traitement en aval.
Par exemple, si une activité Dataflow Gen2 se termine mais qu’une charge d’entrepôt échoue, concentrez-vous sur l’enquête sur la charge plutôt que sur la répétition de la préparation réussie. Notez le résultat de la sortie et l’activité pertinente afin que le prochain déploiement puisse traiter le point de défaillance réel.
-
Configurez les essais et alertes
Définissez des politiques de réessayage sur les activités pouvant se remettre de pannes temporaires. Configurez le nombre de tentatives et le temps d’attente pour qu’ils s’adaptent à l’opération, plutôt que d’appliquer des paramètres identiques à chaque workflow. Une interruption temporaire de la source peut justifier une nouvelle tentative ; un décalage persistant du schéma nécessite une correction, pas des tentatives répétées.
Utilisez Fabric Activator pour les notifications liées aux changements critiques du jeu de données. Il peut envoyer des notifications à Teams et par e-mail lorsque des jeux de données critiques sont modifiés. Gardez les notifications distinctes du comportement de réessai : les réessais tentent à nouveau l’activité, tandis qu’une alerte informe les utilisateurs d’un événement pertinent.
- Choisissez un planning qui correspond au moment où les données sont prêtes et les rapports doivent être mis à jour. Les pipelines Fabric peuvent s’exécuter quotidiennement, hebdomadairement ou à chaque heure. Utilisez un planning quotidien pour un lot de nuit complété, ou un planning horaire lorsque les nouvelles données et flux de travail dépendants nécessitent un traitement plus fréquent.
Révisez chaque planning dans son environnement cible avant le déploiement en production. Un planning de développement peut aider aux tests, mais la production doit refléter le flux de travail métier et la préparation des données. Évitez les exécutions qui se chevauchent lorsqu’une exécution ultérieure dépend de la réussite de la précédente.
- Définitions de versions du pipeline avec Git pour garder les modifications du workflow réexaminées. Fabric workspace L’intégration Git prend en charge Azure DevOps et GitHub. Les plannings de pipeline connectés sont ajoutés au dépôt dans un
.schedulesfichier à l’intérieur de la définition du pipeline, permettant ainsi aux modifications de schedule de voyager avec l’élément lié.Intégrez les modifications Git dans le déploiement : relisez la définition du pipeline et son planning ensemble, puis promouvez la version testée. Cela permet de maintenir le flux de travail et son calendrier alignés entre les environnements au lieu de dépendre de modifications manuelles séparées après le déploiement.
Migration du Fabric et validation du pipeline
Déplacez les artefacts du pipeline à travers des espaces de travail contrôlés, puis validez les dépendances et références avant la production. Les pipelines de déploiement Fabric offrent un chemin de promotion, mais chaque workflow migré nécessite encore des tests.
- Inventez les dépendances du pipeline de l’usine source avant de les reconstruire ou de les promouvoir. Enregistrez les Dataflows liés, Lakehouses, Warehouses, notebooks et rapports en aval liés à chaque pipeline. Cette carte de dépendances aide à identifier quels éléments fondamentaux déployer en premier. Par exemple, déployez un Lakehouse avant un pipeline qui écrit dessus, puis validez la destination et les sorties du pipeline dans son espace de travail cible.
Incluez la source, la destination, les paramètres et les vérifications de données attendues dans l’enregistrement de migration. Ces détails fournissent aux équipes de développement et de test une base cohérente pour valider la fonctionnalité migrée.
- Utilisez les pipelines de déploiement Fabric pour déplacer des artefacts sélectionnés entre les espaces de travail. Leurs étapes par défaut sont Développement, Test et Production. Les options de déploiement sont déploiement complet, sélectif et rétro. Choisissez déploiement complet pour une version coordonnée ou un déploiement sélectif lorsque seuls des artefacts spécifiques ont passé la validation.
Le déploiement en arrière n’est autorisé que lorsque l’étape cible est vide et qu’aucun espace de travail n’est attribué. Considérez cela comme une contrainte de déploiement, et non comme une méthode de retour en arrière de routine. Planifiez la direction de la promotion avant d’attribuer des espaces de travail aux étapes.
- Validez les références après promotion, surtout lorsqu’un pipeline invoque un flux de données. Un pipeline promu continue de référencer le flux de données dans l’espace de travail précédent. Testez cette dépendance dans l’environnement cible, puis mettez à jour ou redéployez les éléments afin que le pipeline utilise le flux de données dans l’espace de travail prévu.
Exécutez le flux de travail complet dans Test, pas seulement la première activité du pipeline. Confirmez que le pipeline lit la source attendue, écrit sur le Lakehouse ou l’Entrepôt prévu, et réussit les vérifications en aval avant la promotion en production.
- Ajoutez des tests de pipeline à Azure DevOps CI/CD avec fabric-cicd, Fabric CLI ou PowerShell. Utilisez des tests pour comparer les définitions d’éléments attendues, les paramètres et les sorties avec la version migrée. Un workflow CI peut déployer un Fabric Data Pipeline pour exécuter des tests après un changement de code, aidant ainsi à détecter une référence cassée avant la publication.
Gardez les modifications de l’espace de travail et du dépôt alignées. L’intégration Fabric Git prend en charge Azure DevOps et GitHub, tandis que les pipelines de déploiement peuvent promouvoir des artefacts spécifiés entre les espaces de travail source et cible via l’API REST.
- Configurez la validation autour des dépendances des artefacts et des sorties métier, plutôt que de vous fier uniquement à un statut de déploiement réussi. Confirmez que les éléments en amont existent, que les activités du pipeline sont terminées et que les données de destination ont la structure attendue. Si un Entrepôt dépend d’une transformation Lakehouse, déployez et validez d’abord le Lakehouse.
Pour les organisations qui modernisent une plateforme de données, la migration de Fabric fonctionne mieux lorsque l’ordre des artefacts, les références d’espace de travail et les tests de pipeline forment un processus de publication unique. Cela offre à chaque promotion une piste de validation claire du développement à la production.
Quelles fonctionnalités de surveillance, de journalisation, de réessayage et d’alerte sont disponibles pour les pipelines Fabric ?
- Examinez chaque pipeline Fabric exécuté au niveau de l’activité. Vérifiez quelles activités ont réussi, échoué ou ont été sautées, puis retracez les dépendances pour localiser la première étape infructueuse. Par exemple, si un carnet échoue après qu’une activité de copie ait réussi, enquêtez les entrées du carnet avant de relancer la copie terminée. Le statut global d’une exécution seul ne montre pas quelle opération nécessite une attention.
Notez le résultat d’exécution, l’élément affecté et le contexte de défaillance dans votre journal opérationnel. Incluez des détails qui aident à distinguer les problèmes de source des problèmes de transformation ou de destination, tels que le nom de l’activité et les paramètres d’entrée pertinents. Cela offre aux équipes de support un point de départ cohérent lorsque le flux de travail redémarre.
- Configurez les politiques de réessayage sur les activités pouvant se remettre d’interruptions temporaires. Les activités Fabric Pipeline prennent en charge des politiques qui spécifient le nombre de réessayages et les temps d’attente. Définissez ces valeurs selon le comportement de l’activité : une interruption temporaire de connexion peut être effacée, tandis qu’un schéma invalide nécessite généralement une entrée corrigée ou un changement de pipeline.
Gardez les paramètres de réessai visibles dans la configuration de l’activité et révisez-les pendant le déploiement. Trop peu de tentatives peuvent laisser un flux de travail récupérable incomplet ; les tentatives répétées sur une erreur persistante peuvent retarder le diagnostic. Associez les réessais à un chemin d’échec clair afin qu’une activité épuisée ne laisse pas les données en aval obsolètes sans préavis.
- Utilisez des alertes pour rendre les événements importants exploitables. Fabric Activator peut envoyer des notifications à Teams et par e-mail lorsque des ensembles de données critiques sont modifiés. Choisissez les jeux de données et les destinataires en fonction de qui doit répondre, puis décrivez l’élément affecté dans le contexte des notifications. Une alerte de changement est utile lorsqu’une modification elle-même nécessite une attention, même si une exécution de pipeline n’a pas échoué.
Pour les réponses basées sur des métriques, Data Activator peut déclencher une action lorsqu’une métrique de qualité dépasse un seuil prédéfini. Associez la métrique à une réponse significative, comme l’investigation d’un changement de complétude. Associez ce seuil à une règle de qualité définie plutôt que de traiter chaque fluctuation comme un incident.
- Acheminez les vérifications pilotées par événements vers le bon composant. Fabric Eventstreams peut transférer des événements vers un webhook pour des analyses personnalisées de conformité et de qualité des données. Ce schéma sépare la capture d’événements du scan externe, facilitant ainsi le diagnostic. Par exemple, un événement de données entrant peut déclencher une vérification webhook avant que les équipes n’agissent sur l’état qualité résultant.
Utilisez des événements de stockage OneLake ou Azure Blob lorsque de nouvelles données doivent initier un flux de travail. Activator peut déclencher des éléments Fabric, y compris les pipelines et les notebooks, en réponse aux événements de fichiers. Maintenez les déclencheurs d’événements, les tentatives de pipeline et les notifications distincts : chacun gère une réponse différente aux données entrantes ou aux problèmes d’exécution.
- Transformez ces contrôles en une séquence de récupération : inspectez l’activité échouée, évaluez ses entrées, autorisez les tentatives configurées, puis notifiez l’équipe compétente si le problème persiste. Appliquez cette séquence de manière cohérente dans les espaces de travail de développement et de production. Pour revoir la conception de la surveillance et de la récupération pour les workflows Fabric, discutez de vos opérations de pipeline avec un spécialiste.
Momentum One : migration et modernisation du Fabric
Momentum One aide les organisations à planifier et à mettre en œuvre la migration et la modernisation Fabric lorsque les pipelines existants nécessitent une transition ou une modernisation structurée. Ce travail peut aligner la conception du pipeline avec le déploiement des espaces de travail, le déplacement des données et les besoins de validation, aidant les équipes à construire un environnement Fabric plus maintenable.
Pour une migration impliquant de nouvelles structures Lakehouse ou Warehouse, Data Warehouse & Lakehouse Design peut façonner l’architecture des données sous-jacente. La modélisation des données et l’optimisation DAX supportent la couche de rapport, tandis que les Solutions de formation aident les équipes à gagner en confiance dans le travail avec les pipelines Fabric et les contrôles qualité.
Si votre prochaine étape consiste à évaluer une migration, à améliorer la fiabilité des pipelines ou à préparer votre équipe à gérer les flux de travail qui en résultent, contactez Momentum One pour discuter de vos besoins.
Préparez votre stratégie de pipeline à évoluer
Une approche durable de l’automatisation des pipelines de données Fabric devrait supporter plus que le prochain déploiement. À mesure que les sources de données, les besoins en reporting et les responsabilités de l’équipe évoluent, une propriété claire et des décisions de conception cohérentes contribuent à maintenir les flux de travail.
Momentum One peut soutenir cette orientation à long terme grâce à la migration et la modernisation Fabric, le conseil et la gouvernance Power BI, ainsi que la modélisation des données et l’optimisation DAX. Ces services relient les changements de plateforme aux considérations de gouvernance et de reporting qui façonnent la manière dont les équipes utilisent leurs données.
Utilisez votre prochaine discussion de planification pour identifier quelle décision de pipeline ou de plateforme ferait la plus grande différence pour les objectifs de votre organisation. Contactez Momentum One pour discuter de vos plans Fabric et envisager une étape concrète pour votre environnement de données.
Questions Fréquemment Posées
Comment automatisez-vous le déploiement de pipelines à travers des environnements Fabric en utilisant CI/CD ?
Utilisez un flux de travail basé sur un dépôt pour tester et promouvoir les définitions de pipeline. Un pattern pratique offre à chaque branche développeur ou branche fonctionnalité un espace de développement dédié, puis fusionne les modifications examinées dans la branche principale. Un push vers main peut déclencher un déploiement en production. Pour maintenir l’automatisation des pipelines de données Fabric maintenable, incluez des tests de déploiement qui vérifient les définitions et dépendances attendues des artefacts, pas seulement si le pipeline démarre avec succès.
Quelles règles de sécurité, d’autorisations et de gouvernance des données s’appliquent aux pipelines Fabric automatisés ?
Limitez les permissions d’espace de travail et de dépôt aux personnes et processus qui en ont besoin, et documentez qui possède chaque pipeline et ses données. L’intégration de Fabric Git nécessite que les paramètres d’administration de l’espace de travail pour créer des éléments Fabric et synchroniser les éléments de l’espace de travail avec les dépôts Git soient activés. Pour l’intégration GitHub, utilisez un jeton à grain fin avec les permissions de lecture et d’écriture pour le contenu, ou un jeton classique avec les champs de dépôt activés.
Quelles sont les défaillances courantes d’automatisation des pipelines Fabric et comment les résoudre ?
Les causes typiques incluent un fichier source manquant, une configuration d’activité invalide, une dépendance indisponible, ou des données qui ne respectent pas une règle de qualité. Commencez par la première activité échouée, inspectez ses détails d’erreur et comparez ses entrées avec la source et les paramètres attendus. Pour les flux de travail pilotés par fichiers, confirmez que le dossier configuré a reçu le fichier prévu. Corrigez ensuite la cause probable et relancez la plus petite partie affectée du pipeline.
Quelles bonnes pratiques réduisent le temps d’exécution du pipeline, les pannes et la capacité inutile ?
Pour une automatisation efficace du pipeline de données Fabric, supprimez les étapes redondantes, évitez de rafraîchir les éléments en aval avant que leurs entrées ne soient prêtes, et ne faites pas attendre inutilement le travail indépendant sur des tâches non liées. Mesurez les exécutions avec des données représentatives et examinez quelles activités consomment le plus de temps ou de capacité. Modifiez une partie du workflow à la fois, puis comparez la qualité d’exécution et de sortie avant d’appliquer le changement en production.
Comment les pipelines Fabric se comparent-ils à Azure Data Factory et à d’autres outils d’orchestration ?
Les Fabric Pipelines partagent une base et des concepts avec Azure Data Factory, incluant activités, déclencheurs, déplacement de données et surveillance. Ils peuvent orchestrer des Dataflows, notebooks, entrepôts et mises à jour de jeux de données Power BI ; le matériel ne permet pas de comparaison avec d’autres outils d’orchestration.