Comment optimiser le DAX pour les grands volumes de données : guide vers un Power BI haute performance
Optimiser le DAX sur de grands volumes de données est déterminant pour livrer des rapports Power BI rapides et réactifs à l'échelle de l'entreprise. Ce guide couvre la conception efficace des mesures, le contexte de filtre, l'optimisation du modèle, les stratégies de calcul et les techniques d'optimisation permettant de réduire les temps de requête dans Power BI et Microsoft Fabric.
- Identifiez le « mur de la performance » et comprenez comment le moteur VertiPaq exploite le stockage en colonnes pour compresser et traiter efficacement d'immenses volumes de données.
- Adoptez un schéma en étoile comme modèle de référence, afin de réduire les jointures à l'exécution et de garder vos mesures DAX simples et rapides.
- Maîtrisez un processus méthodique de refactorisation pour optimiser le DAX sur de grands volumes, en isolant les requêtes problématiques avec l'analyseur de performances et DAX Studio.
- Découvrez comment le mode DirectLake de Microsoft Fabric s'appuie sur les fichiers Parquet pour offrir des performances inférieures à la seconde sur des milliards de lignes, sans import de données traditionnel.
Imaginez l'agacement d'un utilisateur métier qui attend vingt secondes la mise à jour d'un simple segment, alors qu'une réunion décisive est en jeu. C'est une situation que rencontrent beaucoup de professionnels de la donnée à mesure que leurs environnements grandissent et que leurs modèles se complexifient. L' optimisation du DAX pour les grands volumes de données est souvent traitée comme une énigme de syntaxe, alors qu'en réalité la performance est un choix d'architecture. Si votre capacité Power BI Premium peine avec de longues actualisations ou des formules complexes impossibles à déboguer, vous n'êtes pas seul.
Nous sommes convaincus que votre analytique doit avancer aussi vite que vos décisions. Dans ce guide, vous maîtriserez les techniques d'architecture et d'écriture de formules nécessaires pour supprimer les lenteurs de vos rapports et faire évoluer vos modèles sans heurts jusqu'à l'échelle de l'entreprise. Nous vous montrerons comment obtenir des visuels qui se chargent en moins d'une seconde et une utilisation plus efficace des ressources dans Power BI Premium ou Microsoft Fabric. En suivant notre cadre reproductible d'écriture d'un DAX performant, vous transformerez un rapport poussif en un actif réactif et fiable, que vos parties prenantes prendront plaisir à utiliser.
Comprendre le mur de la performance : pourquoi les grands volumes ralentissent le DAX
Lorsque vous créez un premier rapport Power BI, tout paraît rapide. Avec quelques milliers de lignes, vos mesures répondent instantanément. Mais à mesure que vos données approchent les 10 millions de lignes et au-delà, vous heurtez ce que les architectes appellent le « mur de la performance ». Ce n'est pas qu'une affaire de volume : ce sont les limites techniques du traitement des requêtes Data Analysis Expressions (DAX). À cette échelle, la moindre inefficacité syntaxique est amplifiée, et un calcul qui prenait moins d'une seconde se transforme en attente pénible pour l'utilisateur.
Il est essentiel de distinguer rapports lents et actualisations lentes. Une actualisation lente signale généralement un goulet dans votre source de données ou vos transformations Power Query. Un rapport lent, reconnaissable aux icônes qui tournent sur les visuels, relève presque toujours du DAX ou de la modélisation. L' optimisation du DAX pour les grands volumes de données suppose un changement de posture : vous n'écrivez pas seulement des formules, vous pilotez la façon dont le moteur alloue ses ressources.
Moteur de formules et moteur de stockage : le conflit central
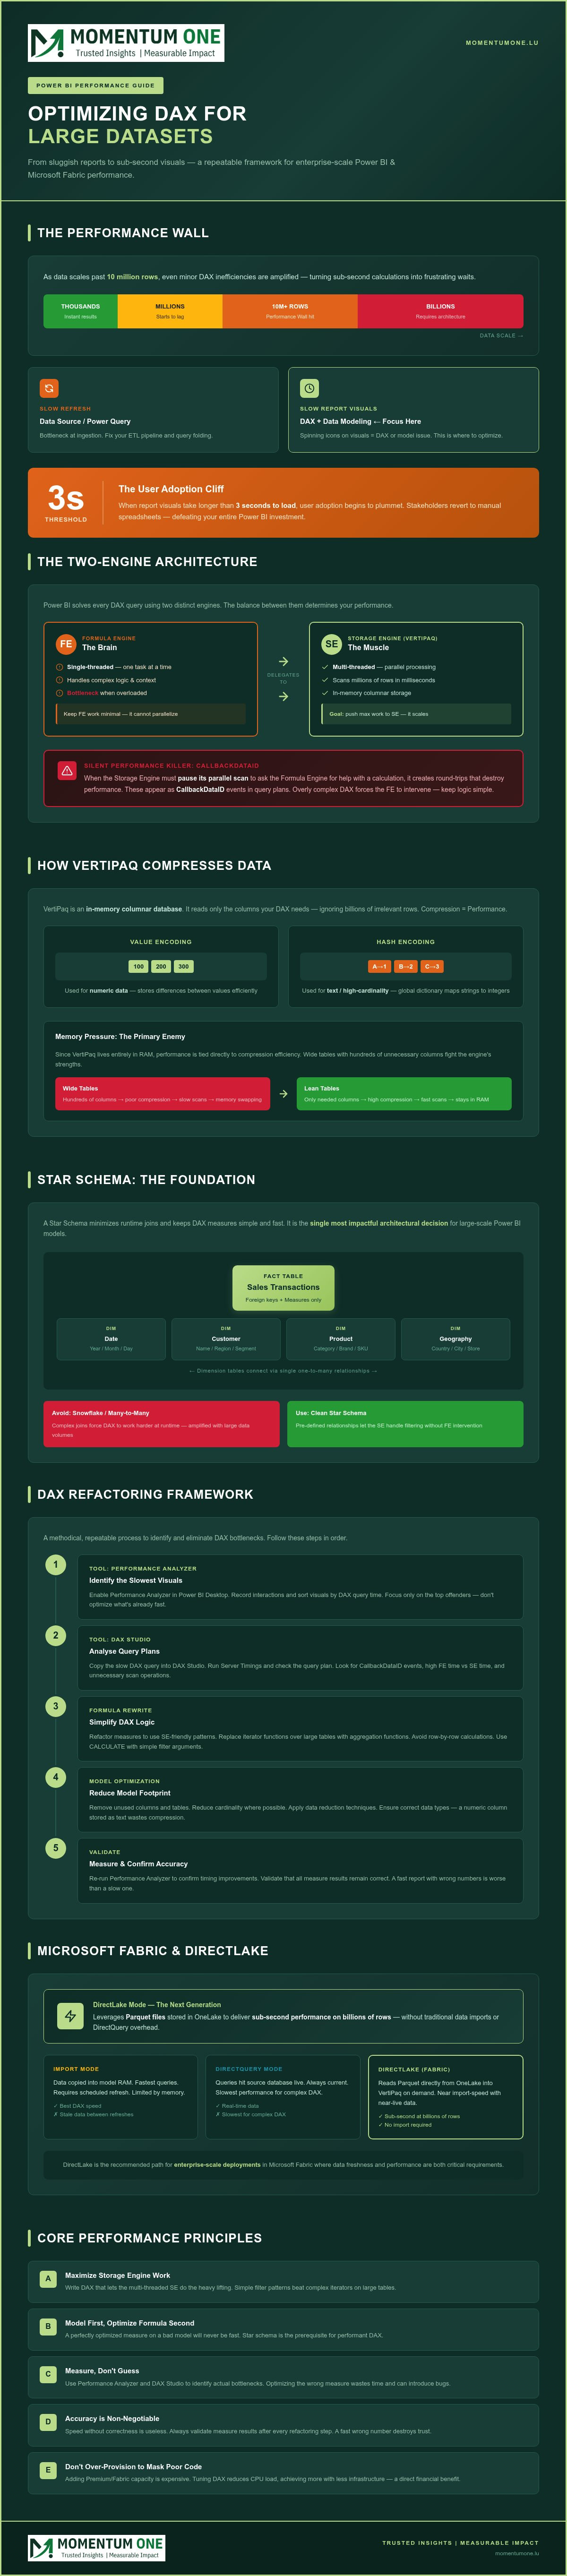
Power BI mobilise deux moteurs pour résoudre vos requêtes DAX. Le moteur de formules (FE) est le « cerveau » : très intelligent, capable de logiques complexes, mais monothread. Il ne traite donc qu'une tâche à la fois. Le moteur de stockage (SE), aussi appelé VertiPaq, est le « muscle » : multithread, conçu pour parcourir des millions de lignes en quelques millisecondes grâce au traitement parallèle.
Les problèmes de performance apparaissent quand le moteur de formules doit assumer trop de travail. Si votre DAX est trop complexe, le FE ne peut pas déléguer la tâche au SE. L'un des « tueurs silencieux » les plus fréquents dans les plans de requête est le CallbackDataID. Il survient lorsque le SE doit interrompre son parcours parallèle rapide pour demander au FE de l'aide sur un calcul précis. Ces allers-retours ruinent la performance. Votre objectif premier dans l' optimisation du DAX pour les grands volumes de données est de garder une logique assez simple pour que le moteur de stockage assume l'essentiel du travail.
L'effet métier de la latence DAX
L'expérience utilisateur est le cœur battant de tout projet analytique. Les observations du secteur indiquent qu'au-delà de trois secondes de chargement d'un visuel, l'adoption s'effondre. Si un tableau de bord paraît poussif, les parties prenantes cessent d'interroger les données : elles retournent à leurs tableurs manuels, ce qui annule tout l'intérêt de votre investissement Power BI.
Au-delà de l'adoption, le coût financier est réel. Beaucoup d'organisations cherchent à forcer la performance en surdimensionnant leur capacité Power BI Premium ou Fabric. C'est une manière coûteuse de masquer un code médiocre. En réglant votre DAX, vous réduisez la charge processeur de votre capacité et faites davantage avec moins. Surtout, vous devez préserver l' exactitude des rapports tout en cherchant la vitesse. Un rapport rapide qui donne le mauvais chiffre est pire qu'un rapport lent. Un DAX performant garantit l'intégrité de vos données tout en offrant une expérience fluide.
Le moteur VertiPaq : comment Power BI traite les grands volumes
Pour comprendre pourquoi certaines formules traînent, il faut regarder sous le capot, du côté du moteur VertiPaq. Cette base de données en colonnes, entièrement en mémoire, est la véritable force de Power BI. Contrairement aux bases traditionnelles qui lisent des lignes entières, VertiPaq ne lit que les colonnes réclamées par votre mesure DAX. Cette conception permet au moteur d'ignorer des milliards de lignes hors sujet pendant un calcul. C'est la pierre angulaire de l' optimisation du DAX pour les grands volumes de données, car elle réduit au minimum la quantité de données à acheminer vers le processeur.
La pression mémoire est l'ennemie principale de ce moteur. Comme VertiPaq réside entièrement en RAM, la performance dépend directement de la qualité de compression de vos données. Si votre modèle est trop volumineux pour tenir confortablement dans la mémoire allouée, le moteur doit décharger des données, d'où une latence considérable. La compression n'est donc pas un simple gain de stockage : c'est une exigence de performance incontournable pour les modèles d'entreprise.
La compression en colonnes et son importance
VertiPaq doit sa rapidité légendaire à des méthodes d'encodage sophistiquées. Il utilise l'encodage par valeur pour les données numériques et l'encodage par hachage pour créer un « dictionnaire global » des valeurs textuelles ou à forte cardinalité. En construisant des tables « larges » de centaines de colonnes, vous allez à l'encontre des forces naturelles du moteur. Chaque colonne inutile abaisse le taux de compression et alourdit l'empreinte mémoire, ce qui ralentit les parcours.
En appliquant les techniques de réduction des données en mode Import, vous permettez à VertiPaq de conserver l'ensemble du jeu de données en mémoire. Ce sont ces parcours ultrarapides qui donnent au DAX son caractère instantané. Choisir les bons types de données et réduire la cardinalité des colonnes sont des gestes simples aux effets spectaculaires sur la vitesse des requêtes.
Repli de requête et localisation des données
La performance ne se joue pas uniquement à l'intérieur de Power BI, mais aussi dans le lieu où le travail s'effectue. Il est essentiel que vos transformations aient lieu au plus près de la source. Lorsque la logique est renvoyée vers la source de données — base SQL ou lakehouse —, le moteur VertiPaq reçoit un jeu de données propre, préfiltré et prêt pour l'analyse.
Dans bien des cas, une conception d'entrepôt de données solide constitue la première étape la plus efficace du réglage DAX. En recourant à des vues matérialisées ou à des tables pré-agrégées à la source, vous réduisez la complexité des calculs que le DAX doit effectuer à l'exécution. Si votre architecture actuelle peine à suivre la croissance de vos volumes, notre équipe peut vous aider à évaluer une stratégie de modernisation de l'architecture de données pour fluidifier vos performances dès la base.
La modélisation : le secret d'un DAX performant
Bien des développeurs passent des heures à retoucher la syntaxe de leurs mesures alors que le vrai goulet se trouve dans les relations sous-jacentes. La règle d'or de Power BI est simple : le DAX est le plus rapide lorsqu'il travaille sur un schéma en étoile. Il est tentant d'envisager le DAX isolément, mais l' optimisation du DAX pour les grands volumes de données est impossible sans un modèle propre. Un modèle bien conçu permet au moteur d'effectuer des parcours simples et efficaces plutôt que des jointures complexes à l'exécution.
Les schémas en flocon sont un piège courant en entreprise. En normalisant les tables de dimensions, vous obligez le moteur à traverser plusieurs relations pour résoudre un seul filtre. Chaque « saut » de relation ajoute de la charge. Sur un jeu de 100 millions de lignes, ces millisecondes de logique de jointure s'accumulent vite et produisent la lenteur que les utilisateurs détestent. Pour viser la performance, vous devez aplatir vos dimensions en un lien unique vers votre table de faits.
Schéma en étoile ou tables à plat
On croit souvent qu'une immense table « à plat » est plus rapide parce qu'elle supprime les relations. En réalité, les tables à plat sont souvent moins performantes sur de grands volumes. Comme le moteur VertiPaq utilise un stockage en colonnes, il est fortement optimisé pour les relations 1:N. Un schéma en étoile lui permet de filtrer une petite table de dimensions, puis d'appliquer le résultat à la grande table de faits via des index bitmap très rapides.
Si vous composez avec un modèle hérité devenu trop complexe, une modernisation de l'architecture de données vous aidera à restructurer ces tables pour le moteur moderne. Passer d'un modèle « spaghetti » désordonné à un schéma en étoile propre est souvent le geste le plus efficace pour accélérer vos requêtes.
Réduire la cardinalité pour mieux compresser
La cardinalité désigne le nombre de valeurs distinctes d'une colonne. C'est le facteur premier de performance du moteur de stockage. Les colonnes à forte cardinalité — identifiants de transaction uniques, GUID, horodatages de haute précision — sont les ennemies de la compression. Elles empêchent le moteur de recourir à un regroupement de bits efficace, d'où une empreinte mémoire excessive et des parcours plus lents.
- Séparez date et heure : ne conservez jamais une colonne DateTime combinée dans une table de faits. Les scinder en colonnes Date et Heure réduit fortement le nombre de valeurs distinctes.
- Arrondissez les décimales : si votre analyse n'exige pas cinq décimales, arrondissez vos colonnes monétaires ou de mesure. Moins de valeurs distinctes, meilleure compression.
- Évitez les colonnes de description : les grands champs de texte doivent vivre dans les tables de dimensions, jamais dans les tables de faits.
- Désactivez la date/heure automatique : ce réglage crée des tables masquées pour chaque colonne de date du modèle. Sur de grands volumes, ce surpoids peut ajouter des centaines de mégaoctets de mémoire inutile.
En vous concentrant sur ces éléments structurels, vous allégez le travail du moteur. Lorsque le modèle est propre, l' optimisation du DAX pour les grands volumes de données devient un travail d'affinage de la logique plutôt qu'un combat contre l'architecture.
Pas à pas : refactoriser le DAX pour gagner en vitesse
L'optimisation du DAX pour les grands volumes de données ne tient pas à la chance : c'est une suite disciplinée d'étapes de diagnostic. Quand un rapport paraît lourd, ne réécrivez pas vos mesures au hasard. Suivez plutôt ce cadre structuré de refactorisation pour localiser et éliminer la cause exacte de la lenteur. Cette démarche méthodique est la manière la plus fiable d' optimiser le DAX pour les grands volumes de données sans introduire d'erreurs de logique.
Étape 1 : utilisez l'analyseur de performances. Ouvrez cet outil dans Power BI Desktop, cliquez sur « Démarrer l'enregistrement », puis sur « Actualiser les visuels ». Repérez le visuel le plus long à s'afficher : c'est lui qui identifie précisément la requête responsable du goulet.
Étape 2 : isolez la requête dans DAX Studio. Copiez le code DAX depuis l'analyseur de performances et collez-le dans DAX Studio. Activez « Server Timings » pour voir la répartition entre moteur de formules et moteur de stockage. Comme nous l'avons vu plus haut, un pourcentage élevé côté FE signale généralement un code trop complexe pour le traitement parallèle.
Étape 3 : remplacez les itérateurs coûteux. Des fonctions comme SUMX ou AVERAGEX peuvent être lentes lorsqu'elles doivent parcourir de grandes tables de faits ligne à ligne. Autant que possible, utilisez des fonctions vectorisées ou faites en sorte que vos itérateurs travaillent sur un sous-ensemble résumé et plus restreint.
Étape 4 : optimisez les fonctions FILTER. Évitez d'appliquer FILTER à une table entière : cela oblige le moteur à parcourir toutes ses colonnes, un gaspillage considérable. Filtrez plutôt des colonnes précises, ou utilisez KEEPFILTERS pour conserver le contexte sans cette charge.
Étape 5 : exploitez les variables (VAR). Les variables sont évaluées une seule fois et leur résultat est mémorisé. Le moteur évite ainsi de recalculer plusieurs fois la même logique au sein d'une mesure, ce qui représente un gain d'efficacité majeur.
Les anti-motifs DAX à éviter
Moderniser son code, c'est aussi abandonner de vieilles habitudes. Par exemple, SELECTEDVALUE est souvent plus rapide et plus lisible que l'ancien motif IF(ISFILTERED(...)). De même, évitez FILTER(ALL(Table), ...) sur des tables de plusieurs millions de lignes : cela produit en mémoire une matérialisation massive non compressée, capable de faire tomber votre capacité. Sur de gros volumes, envisagez des alternatives à DISTINCTCOUNT, comme une table auxiliaire résumée, pour soulager le moteur de stockage.
Des outils avancés pour les experts DAX
Pour aller plus loin, utilisez VertiPaq Analyzer dans DAX Studio afin de repérer les colonnes les plus « lourdes » de votre modèle. Cet outil montre exactement quels champs gonflent votre empreinte mémoire. Savoir lire les plans de requête est une autre compétence décisive : elle vous montre les étapes physiques et logiques suivies par le moteur pour résoudre votre requête. Comme ces techniques exigent une grande précision technique, nos formations Power BI en entreprise sont conçues pour aider vos équipes de développement à maîtriser ces outils avancés. Si votre équipe est prête à cesser de deviner pour commencer à mesurer, nous pouvons vous apporter l'accompagnement structuré nécessaire à une culture de la performance.
Se projeter : Microsoft Fabric et DirectLake
À mesure que 2026 avance, le paysage analytique quitte le Power BI Premium traditionnel (SKU P) pour l'environnement unifié Microsoft Fabric. Cette transition introduit le mode DirectLake, une avancée qui change en profondeur notre façon d'aborder l' optimisation du DAX pour les grands volumes de données. En interrogeant directement les fichiers Delta Parquet dans OneLake, DirectLake supprime les imports de données chronophages tout en conservant la rapidité que les utilisateurs attendent des modèles en mémoire. C'est un bond en avant considérable pour les organisations qui gèrent d'immenses volumes.
Dans ce nouveau paradigme, le moteur de stockage dialogue avec des données conservées dans un format standardisé et compressé. Cela autorise des performances DAX inférieures à la seconde, même sur des jeux de plusieurs milliards de lignes. Cette échelle s'accompagne toutefois de garde-fous précis, à gérer avec attention. Ainsi, un SKU F64 prend en charge jusqu'à 1,5 milliard de lignes par table. Si vous dépassez ces limites, le modèle peut « retomber » en mode DirectQuery, avec des requêtes plus lentes. D'où l'importance d'une feuille de route Fabric moderne bien pensée pour toute entreprise qui veut grandir sans heurter de plafond technique.
DirectLake : le meilleur des deux mondes
DirectLake offre la vitesse du mode Import et la portée en temps réel du DirectQuery. Comme le moteur ne charge en mémoire que les colonnes nécessaires, à la demande, depuis les fichiers Parquet, il allège fortement la charge d'actualisation initiale. Le mode Import reste un excellent choix pour une complexité DAX maximale sur de plus petits volumes, mais DirectLake s'impose nettement pour des données massives et à forte vélocité. Vos mesures les plus complexes restent ainsi réactives, même quand votre lac de données atteint le pétaoctet.
L'efficacité est aussi une priorité financière dans l'écosystème Fabric. Comme Fabric fonctionne sur un modèle de capacité, un DAX inefficace ne ralentit pas seulement les rapports : il consomme davantage d'unités de capacité (CU) et alourdit vos coûts d'exploitation. L' optimisation du DAX pour les grands volumes de données n'est donc plus seulement une question d'expérience utilisateur : c'est un levier direct de maîtrise des coûts dans votre environnement cloud. Un code performant vous permet de tirer le meilleur de votre investissement F-SKU tout en offrant une expérience fluide à vos parties prenantes.
Performance managée : l'approche Momentum One
Maintenir un environnement performant demande plus qu'une correction ponctuelle. La dérive des performances s'installe souvent à mesure que de nouvelles mesures s'ajoutent et que les volumes augmentent. Nos services Power BI managés assurent une supervision proactive des métriques de capacité et des durées de requête, afin de détecter les goulets avant qu'ils n'affectent vos utilisateurs. Nous sommes votre stratège de confiance : nous auditons et réglons vos modèles critiques pour qu'ils restent sobres et efficaces. Ce partenariat permet à vos équipes internes de se concentrer sur la production d'analyses pendant que nous prenons en charge le travail technique de gouvernance des performances et de santé architecturale.
Bâtir un socle pour des analyses évolutives
Maîtriser la performance dans Power BI suppose de dépasser les formules de base pour comprendre en profondeur l'architecture du moteur. En privilégiant un schéma en étoile propre et en déplaçant les calculs lourds du moteur de formules monothread vers le moteur de stockage parallèle, vous supprimez les lenteurs qui agacent vos utilisateurs métier. L' optimisation du DAX pour les grands volumes de données est un engagement continu de qualité technique, qui garde vos rapports réactifs à mesure que vos volumes progressent vers le milliard de lignes.
À mesure que vous migrez vers des environnements modernes comme Microsoft Fabric, ces techniques d'optimisation deviennent encore plus décisives pour maintenir des temps de chargement inférieurs à la seconde et maîtriser vos coûts de capacité. Microsoft Solutions Partner certifié, Momentum One est spécialisé dans la performance de Fabric et de Power BI Premium. Notre expérience éprouvée des modèles de données à l'échelle de l'entreprise nous permet d'auditer votre environnement et d'y déceler les goulets cachés. Faites évoluer votre analytique avec les services professionnels d'optimisation DAX de Momentum One et transformez vos données en un actif stratégique à grande vitesse. Ne laissez pas la dette technique freiner votre progression : bâtir aujourd'hui une architecture solide vous rapportera pendant des années.
Questions Fréquemment Posées
Quelle est la cause la plus fréquente de lenteur du DAX sur de grands volumes ?
La cause la plus fréquente est un modèle de données mal conçu, sans schéma en étoile clair. Lorsque les relations sont trop complexes ou suivent un schéma en flocon, le moteur doit effectuer des jointures coûteuses à l'exécution. Le moteur de formules monothread travaille alors davantage, ce qui mène au mur de la performance. Relier directement vos tables de faits à vos dimensions est la première étape de l'optimisation du DAX sur de grands volumes.
Faut-il toujours utiliser des variables (VAR) dans ses mesures DAX pour gagner en vitesse ?
Vous devriez utiliser des variables dans presque toutes les mesures complexes, tant pour la vitesse que pour la lisibilité du code. Une variable évalue un bloc logique une seule fois et en stocke le résultat comme une constante, ce qui évite à Power BI de recalculer plusieurs fois la même expression. C'est particulièrement utile dans les logiques conditionnelles de type IF ou SWITCH. Au-delà de la performance, cela rend votre DAX bien plus facile à déboguer et à lire pour votre équipe.
En quoi la cardinalité influence-t-elle la vitesse de mes rapports Power BI ?
La cardinalité conditionne directement la qualité de compression des données en mémoire par le moteur VertiPaq. Les colonnes à forte cardinalité, comme des identifiants uniques ou des horodatages de haute précision, créent de vastes dictionnaires qui gonflent la taille du modèle. Comme le moteur doit parcourir ces colonnes pendant les calculs, davantage de données en RAM signifie des requêtes plus lentes. Réduire la cardinalité en arrondissant les nombres ou en scindant les colonnes est une tactique centrale d'optimisation du DAX sur de grands volumes.
Vaut-il mieux effectuer les calculs dans Power Query ou en DAX pour la performance ?
Il est presque toujours préférable d'effectuer les transformations structurelles et les précalculs dans la source de données ou dans Power Query, plutôt que d'utiliser des colonnes calculées DAX. Le DAX est conçu pour des agrégations dynamiques qui varient selon les filtres de l'utilisateur. Si une valeur peut être déterminée avant que les données n'entrent dans le modèle, la remonter en amont allège la charge processeur pendant l'interaction avec le rapport. Vos mesures DAX restent ainsi sobres et centrées sur la logique d'exécution.
Quels outils utiliser pour déboguer des mesures DAX lentes ?
Servez-vous de l'analyseur de performances de Power BI Desktop pour repérer les visuels lents, et de DAX Studio pour entrer dans le détail de la mécanique des requêtes. L'analyseur de performances indique le temps consacré aux requêtes DAX par rapport au rendu visuel. Une fois la mesure lente isolée, la fonction Server Timings de DAX Studio révèle si le goulet se situe dans le moteur de formules ou dans le moteur de stockage. Ces outils sont indispensables à tout audit de performance professionnel.
Microsoft Fabric peut-il aider à résoudre les problèmes de performance DAX ?
Microsoft Fabric introduit le mode DirectLake, qui améliore les performances en interrogeant les fichiers Parquet dans OneLake, sans import de données traditionnel. Ce mode offre la vitesse du mode Import tout en absorbant des milliards de lignes qui dépasseraient normalement les limites de capacité. Il permet également à vos mesures DAX de dialoguer avec une couche de données unifiée, ce qui réduit la latence liée aux déplacements de données entre les différentes étapes de votre chaîne analytique.
Combien de lignes Power BI peut-il traiter avant que le DAX ne ralentisse ?
Il n'existe pas de limite stricte, mais les performances commencent généralement à se dégrader autour de 10 millions de lignes si votre DAX n'est pas optimisé. Power BI sait traiter des milliards de lignes, mais la complexité de vos mesures et la cardinalité de vos colonnes déterminent le point de rupture. Si vos requêtes dépassent 500 ms sur un jeu de données, quelle que soit sa taille, c'est le signe clair que votre architecture ou votre syntaxe mérite une revue professionnelle.
Une relation « plusieurs-à-plusieurs » ralentit-elle vraiment les calculs DAX ?
Oui : les relations plusieurs-à-plusieurs ralentissent nettement les calculs, car elles obligent le moteur à construire en mémoire de grandes tables étendues temporaires. Ce traitement est coûteux en calcul et empêche souvent le moteur de stockage d'emprunter ses chemins de traitement parallèle les plus rapides. Autant que possible, résolvez ces relations à l'aide d'une table de liaison ou en refondant votre modèle en un schéma en étoile 1:N standard, afin de conserver des temps de réponse inférieurs à la seconde.