Comment interroger vos données avec Databricks SQL : guide étape par étape
Libérez des analyses hautement performantes. Découvrez comment interroger vos données avec Databricks SQL, écrire du code efficace grâce à l'IA et sécuriser vos actifs avec Unity Catalog dans ce gu...
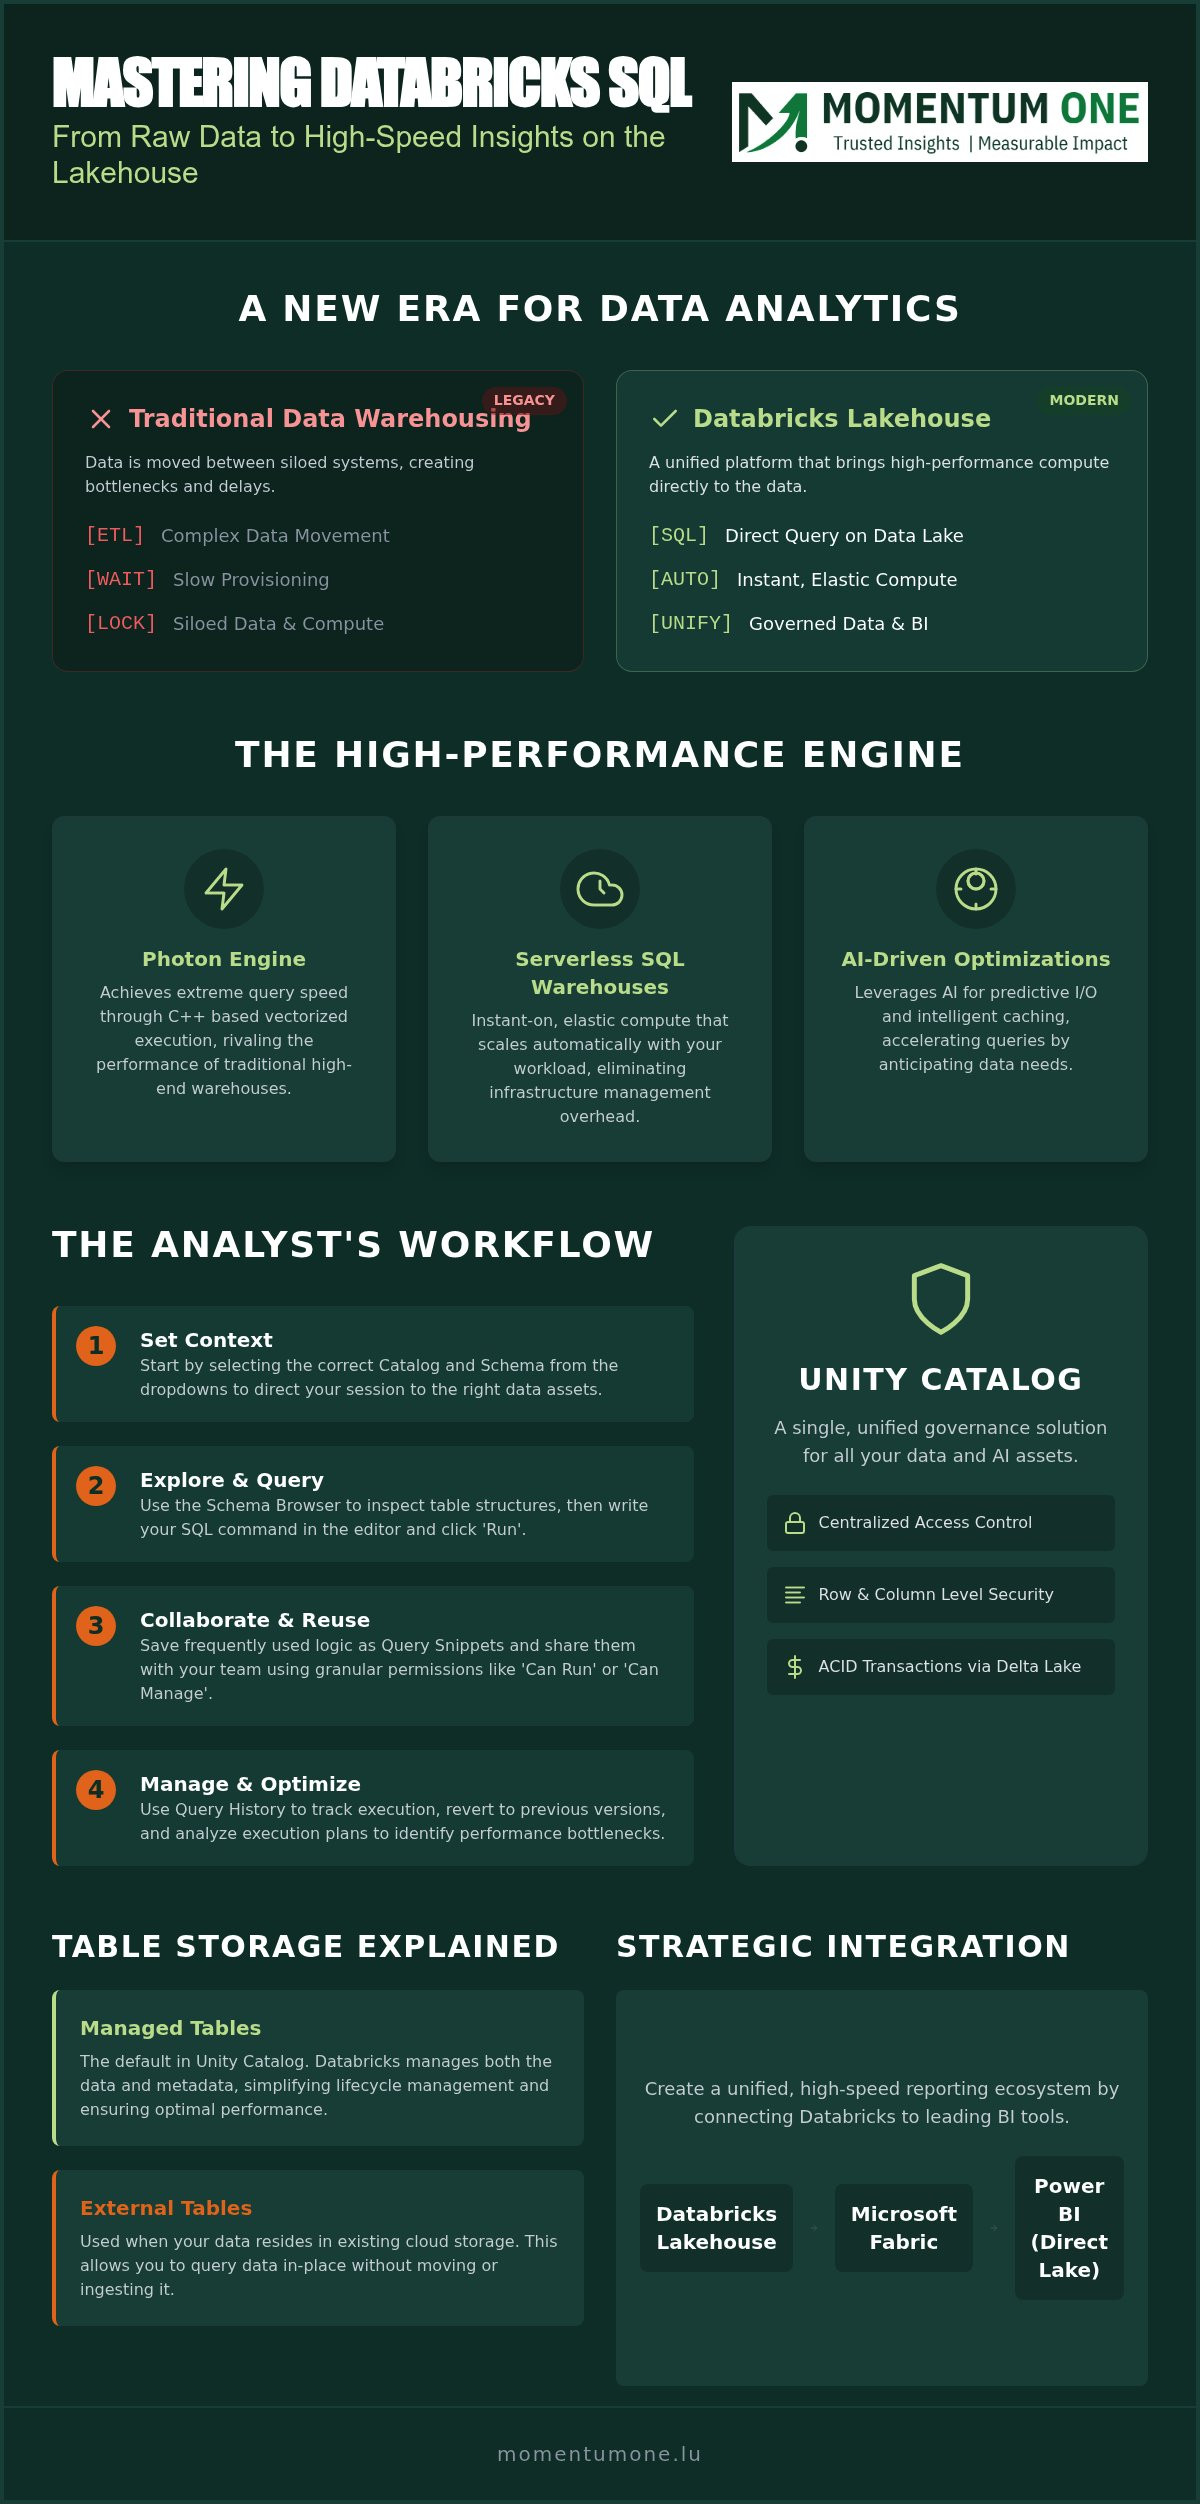
- Comprenez comment passer de l'entrepôt de données traditionnel à une architecture lakehouse serverless pour gagner en agilité opérationnelle.
- Maîtrisez le flux de travail de l'éditeur SQL pour interroger vos données avec Databricks SQL tout en gardant un contrôle précis sur le contexte de votre catalogue et de votre schéma.
- Sécurisez les actifs de votre entreprise avec Unity Catalog pour mettre en place un contrôle d'accès robuste et granulaire, au niveau des lignes comme des colonnes.
- Tirez parti du moteur vectorisé Photon et des optimisations prédictives pilotées par l'IA pour obtenir des analyses performantes, même sur les plus grands volumes de données.
- Intégrez Databricks à Microsoft Fabric et Power BI via le mode Direct Lake afin de créer un écosystème de reporting unifié et ultra-rapide.
Et si la barrière entre votre vaste data lake et vos outils de business intelligence n'était pas une limite technique, mais simplement une question de choix d'interface ? La plupart des équipes data se heurtent aux frictions liées à la gestion des tables externes ou attendent de longues minutes que leurs requêtes renvoient des résultats depuis un lakehouse tentaculaire. Vous avez sans doute ressenti cette frustration de vouloir maintenir les performances alors que vos jeux de données croissent de façon exponentielle. Apprendre à interroger efficacement vos données avec Databricks SQL peut transformer ce goulet d'étranglement en avantage concurrentiel.
Ce guide vous aidera à maîtriser les fondamentaux de l'environnement Databricks SQL et à libérer des analyses hautement performantes, sans les habituels casse-tête d'architecture. Nous verrons comment écrire des requêtes efficaces, tirer parti du codage assisté par l'IA pour accélérer votre travail et utiliser Unity Catalog pour garder des données gouvernées et sécurisées. À la fin, vous disposerez d'une trajectoire claire pour bâtir une stratégie de données rapide et évolutive, qui comble l'écart entre le stockage brut et les décisions concrètes.
Comprendre Databricks SQL à l'ère du lakehouse
Le passage de l'entrepôt de données traditionnel à une architecture lakehouse représente un changement fondamental dans la façon de travailler des équipes data. Autrefois, les organisations devaient déplacer les données entre des silos pour en tirer des enseignements ; aujourd'hui, l'objectif est d'amener le calcul là où se trouvent les données. Databricks a été pionnier de cette approche en créant une plateforme unifiée qui combine le meilleur des data lakes et des entrepôts de données. Au cœur de cette stratégie se trouve Databricks SQL, une couche de calcul serverless conçue spécifiquement pour l'analytique haute performance.
Lorsque vous interrogez vos données avec Databricks SQL, vous n'exécutez pas un simple script. Vous vous appuyez sur un moteur spécialisé qui maîtrise les subtilités du stockage cloud tout en offrant l'interface familière d'un entrepôt classique. Le SQL reste la lingua franca de l'intelligence des données, car il permet aux analystes et aux professionnels de la BI de travailler avec leurs compétences existantes, sans devoir apprendre du code Spark ou Python complexe. En 2026, le passage des éditeurs hérités à l'environnement SQL unifié est devenu la norme et offre une expérience plus fluide et plus réactive aux équipes techniques.
Tables managées et tables externes
Comprendre la façon dont vos données sont stockées est déterminant pour les performances. Les tables managées constituent le mode par défaut dans Unity Catalog : la plateforme gère à la fois les données et les métadonnées, ce qui simplifie la gestion du cycle de vie. Les tables externes conviennent mieux aux cas où les données résident déjà dans un stockage objet cloud et doivent être exploitées sans être déplacées. Quel que soit le type de table, Delta Lake fournit la couche de fiabilité sous-jacente qui garantit les transactions ACID et évite la corruption des données lors d'opérations complexes.
Le rôle des entrepôts SQL serverless
La gestion de l'infrastructure occupait autrefois les ingénieurs data à plein temps. Les entrepôts SQL serverless changent la donne en offrant une capacité de calcul élastique, disponible instantanément et dimensionnée automatiquement selon votre charge de travail. La charge d'administration des équipes BI s'en trouve réduite : elles peuvent se concentrer sur la production d'analyses plutôt que sur le réglage des clusters. Choisir cette approche serverless est une décision clé dans votre conception lakehouse ou entrepôt de données, car elle conditionne directement votre capacité à fournir un reporting en temps réel aux parties prenantes, sans le délai du provisionnement traditionnel. C'est une manière efficace et rassurante de maintenir des performances optimales dans des environnements de données d'entreprise complexes.
Prendre en main l'éditeur SQL et les espaces de travail Databricks
Pour commencer, ouvrez l'éditeur SQL en sélectionnant l'icône « SQL » dans la barre latérale. Cet espace de travail sert de poste de commande pour toutes vos tâches analytiques. Une fois l'éditeur ouvert, votre première priorité consiste à choisir le bon contexte de catalogue et de schéma dans les menus déroulants situés en haut. Cette étape est essentielle, car elle oriente votre session vers les actifs de données gérés dans Unity Catalog. En 2026, cette interface unifiée est devenue le principal point d'entrée des équipes vers le lakehouse et offre un passage fluide de la donnée brute à l'analyse.
L'explorateur de schémas, à gauche, fournit une carte stratégique de votre environnement de données. Vous pouvez explorer la structure des tables, les types de données et même prévisualiser un échantillon de lignes avant d'écrire la moindre ligne de code. Lorsque vous êtes prêt à interroger vos données avec Databricks SQL, saisissez simplement votre commande et cliquez sur « Run ». Les résultats s'affichent en temps réel, souvent grâce au moteur Photon, dont l'exécution vectorisée offre des performances comparables à celles des entrepôts haut de gamme traditionnels. Cette combinaison de visibilité et de rapidité vous permet de valider votre logique instantanément.
Fonctionnalités d'organisation et de collaboration
L'efficacité d'une équipe data moderne repose sur des actifs réutilisables. Les extraits de requêtes vous permettent d'enregistrer des logiques SQL fréquemment utilisées, comme des jointures complexes ou des calculs d'exercice fiscal standard, et de les mettre à disposition de toute l'équipe. Cette approche collaborative réduit les erreurs et garantit la cohérence des rapports. Le partage de ces requêtes est tout aussi simple : vous pouvez accorder à vos collègues des autorisations précises telles que « Can Run » ou « Can Manage ». Les fonctions d'édition collaborative permettent même à plusieurs membres de travailler simultanément sur le même script, favorisant un environnement proactif où la connaissance circule librement.
Gérer l'historique des requêtes et le versionnement
La stabilité est essentielle à une gestion professionnelle des données. L'onglet « Query History » constitue un journal fiable de chaque instruction exécutée dans votre espace de travail. Si une modification récente produit des résultats inattendus, vous pouvez rapidement consulter les versions précédentes et revenir à un état connu comme fiable. Cet onglet offre également une grande transparence technique grâce aux plans d'exécution. En les analysant, vous identifiez les goulets d'étranglement : brassage de données inutile, index manquants, etc. Pour les organisations qui souhaitent optimiser ces environnements et en maximiser le débit, nos services de gestion des espaces de travail et des capacités apportent l'expertise nécessaire au maintien d'un lakehouse sobre et performant.
Au-delà des requêtes de base : la gouvernance avec Unity Catalog
La gouvernance est souvent perçue comme un obstacle, mais dans un environnement lakehouse mature, elle constitue le socle de la confiance. Unity Catalog joue le rôle de cerveau central de votre patrimoine de données et fournit une interface de découverte unifiée à l'échelle de toute l'entreprise. Lorsque vous interrogez vos données avec Databricks SQL, vous évoluez dans un cadre qui trace automatiquement la lignée des données. Vous voyez ainsi précisément d'où provient un jeu de données et comment il a été transformé à chaque étape de son cycle de vie. Pour nos clients du marché luxembourgeois, cet audit centralisé n'est pas une simple fonctionnalité : c'est une exigence incontournable pour respecter des normes de conformité strictes en 2026. Il donne à votre DPO et à vos équipes informatiques la sérénité nécessaire pour se développer sans compromettre la sécurité.
Mettre en œuvre la sécurité au niveau des lignes
La sécurité doit être dynamique, et non figée. En utilisant des prédicats SQL dans Unity Catalog, vous filtrez les données à la source, en fonction des rôles ou des attributs des utilisateurs. Un directeur régional ne verra par exemple que les chiffres de vente de son territoire, même s'il interroge la même table globale que le directeur financier. Les informations financières ou personnelles sensibles restent ainsi protégées lorsqu'elles sont consultées depuis des outils de BI. C'est une manière proactive de maîtriser le risque sans créer de jeux de données dupliqués et obsolètes pour chaque équipe. Si vous souhaitez aligner ces couches de sécurité avec votre stratégie de reporting, notre équipe propose un accompagnement spécialisé en conseil et gouvernance Power BI pour bâtir un pipeline fluide et sécurisé, du lakehouse jusqu'au tableau de bord.
Lakehouse Federation et systèmes externes
Les silos de données persistent souvent parce que déplacer d'énormes volumes est lent, coûteux et source d'erreurs. Lakehouse Federation résout ce problème en vous permettant d'interroger directement des systèmes externes comme SQL Server ou Snowflake depuis votre environnement Databricks. Vous n'avez pas besoin de migrer chaque octet pour obtenir une vision complète de la performance de votre activité. Cette capacité vous permet de conserver une « source unique de vérité », que nous définissons comme un point d'accès unifié et gouverné où toutes les parties prenantes trouvent des données cohérentes et vérifiées, quel que soit leur lieu de stockage physique. C'est une manière stratégique d'interroger vos données avec Databricks SQL tout en valorisant votre infrastructure existante. Cette approche fait tomber les murs entre des plateformes hétérogènes et permet à vos équipes de consacrer plus de temps à l'analyse et moins au déplacement des données.
Maximiser les performances : moteur Photon et SQL assisté par l'IA
Le moteur Photon représente l'étape suivante de l'analytique haute performance. Contrairement au traitement traditionnel ligne par ligne, Photon recourt à une exécution vectorisée qui traite des lots de données simultanément. Ce changement d'architecture garantit que, lorsque vous interrogez vos données avec Databricks SQL, vous obtenez le débit maximal de votre matériel sous-jacent. Il est particulièrement efficace pour les charges de travail à forte lecture et les agrégations complexes qui ralentissent habituellement les moteurs SQL standard. En 2026, ces expériences intelligentes se sont enrichies d'interfaces en langage naturel, permettant de poser des questions complexes sans mémoriser chaque détail du schéma.
Les optimisations prédictives vont encore plus loin en ajustant automatiquement l'organisation de vos données. La plateforme analyse vos habitudes de requêtage et adapte la taille des fichiers et les métadonnées pour rendre les exécutions suivantes encore plus rapides. Cette approche non intrusive des performances permet à vos équipes de se concentrer sur les analyses stratégiques plutôt que sur la maintenance manuelle. C'est un moyen fiable de conserver la vitesse à mesure que votre lakehouse grandit, sans dégradation des performances au fil du temps.
Techniques d'optimisation des requêtes
Le moteur a beau être puissant, certaines techniques améliorent nettement vos résultats. L'indexation Z-Order est une méthode de référence pour le data skipping : elle regroupe les informations liées dans les mêmes fichiers, ce qui réduit fortement le volume de données que le moteur doit lire. L'optimisation des jointures et des agrégations est également essentielle sur des jeux de données à l'échelle de l'entreprise. Si votre reporting peine à suivre le rythme de votre lakehouse, nos experts en optimisation DAX peuvent combler l'écart de performance au sein de votre environnement Power BI.
Développement SQL assisté par l'IA
Les assistants IA modernes intégrés à l'éditeur SQL se comportent comme de véritables partenaires pour vos analystes. Ces outils vont bien au-delà de la simple complétion automatique : ils suggèrent des jointures à partir du sens de vos données et corrigent même les erreurs de syntaxe en temps réel. La barrière d'entrée s'en trouve abaissée pour les analystes non techniciens, qui peuvent interroger leurs données avec Databricks SQL avec l'assurance d'un ingénieur chevronné. En proposant des suggestions intelligentes qui tiennent compte des métadonnées de votre Unity Catalog, ces assistants garantissent un code à la fois efficace et exact dès la première exécution.
Pour que vos équipes soient pleinement outillées face à ces fonctionnalités avancées, découvrez nos formations entreprise au data fabric et maîtrisez les dernières avancées de l'analytique assistée par l'IA.
Mise en œuvre stratégique : l'intégration avec Microsoft Fabric
En 2026, de nombreuses organisations luxembourgeoises ont compris qu'une approche hybride constitue la voie la plus solide pour l'analytique d'entreprise. Positionner Databricks SQL comme moteur haute performance de Microsoft Fabric vous permet d'associer une puissance de calcul de premier plan à l'écosystème de business intelligence le plus répandu. Lorsque vous interrogez vos données avec Databricks SQL dans un environnement Fabric, vous faites tomber le mur entre l'ingénierie des données et la business intelligence. Cet alignement stratégique donne à vos équipes techniques la puissance dont elles ont besoin, tout en offrant à vos utilisateurs métier la réactivité qu'ils attendent.
Le mode Direct Lake fait office de pont dans cette architecture. Il permet à Power BI de se connecter à vos tables Delta dans OneLake sans la surcharge habituelle liée au déplacement des données ni la latence du DirectQuery standard. Moderniser des entrepôts de données hérités selon une feuille de route stratégique n'est plus un simple projet informatique : c'est une transformation fondamentale de l'entreprise. Un partenaire professionnel est indispensable pour les migrations d'envergure, car il apporte la maîtrise nécessaire pour naviguer dans la complexité technique sans perturber les opérations quotidiennes. Cette approche collaborative garantit une transition vers un lakehouse moderne à la fois fluide et orientée performance.
La synergie entre Databricks SQL et Power BI
Le lien entre ces plateformes n'a jamais été aussi étroit. Vous pouvez désormais publier des jeux de données directement vers les outils de BI sans avoir à gérer de pilotes ou de passerelles complexes. La gouvernance granulaire mise en place dans Unity Catalog est ainsi préservée jusqu'au rapport consulté par l'utilisateur final. Pour les équipes qui souhaitent mener cette transition en douceur, nos services de migration vers Microsoft Fabric offrent un cadre éprouvé. Cette synergie vous permet d'interroger vos données avec Databricks SQL tout en délivrant des visualisations ultra-rapides aux parties prenantes de toute l'organisation.
Construire une architecture de données évolutive
Concevoir pour la croissance future est une priorité pour les entreprises luxembourgeoises. À mesure que les jeux de données gagnent en complexité et en diversité, disposer de fondations évolutives est le seul moyen de conserver un avantage concurrentiel. Nous proposons des services managés de supervision continue de votre environnement, afin que votre lakehouse reste optimisé et maîtrisé côté coûts au fil de l'évolution de votre activité. Si vous êtes prêt à franchir l'étape suivante, nous vous invitons à réserver une revue d'architecture de données avec nos spécialistes. Cette démarche proactive garantit que votre architecture est prête pour les exigences de 2026 et au-delà, et vous offre une plateforme stable pour une croissance et une innovation durables.
Moderniser votre chaîne analytique pour 2026
Passer à une architecture lakehouse moderne ne se résume pas à la vitesse brute : il s'agit de créer un environnement unifié et gouverné dans lequel l'information circule librement. Vous avez vu combien le moteur Photon et les outils assistés par l'IA facilitent plus que jamais le fait d' interroger vos données avec Databricks SQL. En vous appuyant sur Unity Catalog pour une sécurité robuste et en vous intégrant naturellement à Microsoft Fabric, votre organisation peut enfin combler l'écart entre le stockage brut des données et une business intelligence hautement performante.
Aborder ces mutations techniques demande une main sûre et une feuille de route claire. Partenaire Microsoft certifié établi au Luxembourg, Momentum One apporte un conseil stratégique et une expertise pointue en intégration Fabric et Databricks. Nous accompagnons les entreprises dans la construction d'environnements évolutifs qui traversent le temps. Optimisez votre architecture de données avec Momentum One et donnez à vos équipes les outils et les repères nécessaires à une performance optimale. Votre trajectoire data est une évolution : avec les bonnes fondations, les possibilités de croissance sont sans limite.
Questions Fréquemment Posées
Quelle est la différence entre Databricks SQL et le SQL standard ?
Databricks SQL est une variante de SQL spécialisée, optimisée pour l'architecture lakehouse. Elle prend en charge le SQL ANSI standard, mais y ajoute des extensions dédiées aux fonctionnalités de Delta Lake, comme le time travel et la gestion des métadonnées. Contrairement au SQL standard d'un SGBDR traditionnel, elle s'exécute sur un moteur de calcul distribué conçu pour de très grandes échelles. Vous pouvez ainsi interroger vos données avec Databricks SQL sur des pétaoctets d'informations, sans la dégradation de performance habituellement constatée sur les systèmes hérités.
Puis-je interroger des sources de données externes directement depuis Databricks SQL ?
Oui, vous pouvez interroger des sources externes grâce à Lakehouse Federation. Cette fonctionnalité vous permet de créer des connexions vers des bases de données telles que SQL Server, Snowflake ou PostgreSQL directement dans l'environnement Databricks. En référençant ces systèmes externes sous forme de catalogues, vous pouvez joindre des données issues de sources hétérogènes sans réaliser de migration complète. C'est un moyen stratégique d'éliminer les silos et de conserver une source unique de vérité sur l'ensemble de votre patrimoine de données.
Comment le moteur Photon améliore-t-il les performances des requêtes ?
Photon est un moteur de requêtes vectorisé haute performance écrit en C++ qui accélère les charges de travail SQL. Il améliore les performances en traitant les données par lots plutôt que ligne par ligne, ce qui maximise l'efficacité du processeur et la bande passante mémoire. Cette architecture est particulièrement efficace pour les jointures complexes et les agrégations courantes dans l'analytique moderne. En s'appuyant sur Photon, les équipes obtiennent des gains de vitesse significatifs sur les grands volumes de données par rapport aux moteurs d'exécution basés sur Spark utilisés les années précédentes.
Unity Catalog est-il obligatoire pour interroger des données dans Databricks ?
Sans être strictement obligatoire pour les opérations de base, Unity Catalog est fortement recommandé pour toute mise en œuvre à l'échelle de l'entreprise. Il fournit une couche de gouvernance centralisée qui gère les autorisations, l'audit et la traçabilité des données dans votre espace de travail. Sans lui, vous restez limité aux configurations héritées du Hive Metastore, dépourvues de contrôle d'accès granulaire. En 2026, la plupart des organisations considèrent Unity Catalog comme un composant essentiel pour maintenir un environnement lakehouse sûr et conforme aux exigences réglementaires nationales.
Comment connecter Power BI à un entrepôt SQL Databricks ?
La connexion à Power BI est simple grâce au connecteur natif Databricks. Il vous suffit de renseigner le nom d'hôte du serveur et le chemin HTTP indiqués dans les paramètres de votre SQL Warehouse. Pour une expérience optimale, nous recommandons d'utiliser le mode Direct Lake en 2026 : il permet à Power BI de lire directement les tables Delta, sans importation de données ni connexion DirectQuery lente. Cette synergie garantit des rapports réactifs, même à mesure que vos volumes de données augmentent.
Quelles sont les implications financières des entrepôts SQL serverless ?
Les entrepôts SQL serverless fonctionnent selon un modèle de paiement à l'usage, très économique pour les charges de travail variables. Vous ne payez pas les périodes d'inactivité, car les ressources de calcul démarrent et s'arrêtent automatiquement en fonction de la demande. Si le coût unitaire peut être supérieur à celui des clusters classiques, la réduction de la charge d'administration et la suppression des capacités inutilisées se traduisent souvent par un coût total plus faible. C'est une manière fiable de faire évoluer vos analyses sans la contrainte du provisionnement d'infrastructure.
Puis-je interroger mes données dans Databricks en langage naturel en 2026 ?
Les assistants dopés à l'IA vous permettent désormais d'interroger vos données avec Databricks SQL à partir d'instructions en langage naturel. L'assistant IA intégré comprend le contexte de votre schéma et traduit des questions formulées simplement en code SQL valide. Cette capacité abaisse fortement la barrière d'entrée pour les analystes métier qui ne sont pas experts en SQL. Elle aide également les développeurs expérimentés en générant du code standard complexe et en corrigeant instantanément les erreurs de syntaxe, ce qui rend le développement plus proactif et plus efficace.
Comment gérer les autorisations sur les données sensibles dans Databricks ?
Les autorisations se gèrent via Unity Catalog, à l'aide d'instructions SQL GRANT standard ou de l'interface de la console du compte. Vous pouvez mettre en place un contrôle d'accès granulaire, y compris une sécurité au niveau des lignes et des colonnes, afin que chaque utilisateur ne voie que les données correspondant à son rôle. Cette approche centralisée simplifie l'audit et la conformité. Pour les environnements complexes, nos services managés assurent une supervision continue afin que vos politiques de sécurité restent robustes à mesure que votre architecture de données évolue et s'étend.