Tirer parti d'Apache Spark dans les architectures lakehouse modernes
Découvrez comment Apache Spark dans les lakehouses résout la latence et la complexité. Unifiez entrepôt et lac de données pour une analytique en temps réel et des analyses plus rapides.
- Comprenez comment l'architecture lakehouse supprime les silos en associant la souplesse d'un lac de données à la performance d'un entrepôt structuré.
- Découvrez pourquoi Apache Spark dans les lakehouses est le moteur indispensable d'un traitement en mémoire à grande échelle et d'une analytique en temps réel en 2026.
- Maîtrisez les techniques d'optimisation qui règlent la latence et maîtrisent les coûts d'exploitation, en traitant des goulets courants comme le brassage de données.
- Explorez l'intégration fluide de Spark dans l'écosystème Microsoft Fabric pour créer une véritable source unique de vérité dans toute l'organisation.
- Obtenez une feuille de route claire pour migrer vos pipelines hérités vers un environnement moderne et managé, qui grandit sans effort avec vos volumes.
Si votre stratégie data vous oblige encore à choisir entre la rapidité d'un entrepôt de données et l'échelle d'un lac de données, vous payez sans doute une « taxe de complexité » qui freine votre croissance. C'est une frustration courante chez les dirigeants qui se retrouvent à administrer des silos séparés et déconnectés pour le décisionnel d'un côté, l'apprentissage automatique de l'autre. Vous avez probablement remarqué que la latence des pipelines ETL traditionnels rend vos rapports obsolètes avant même qu'ils n'atteignent les décideurs. Nous partageons votre avis : faire grandir vos traitements de données ne devrait pas ressembler à une lutte contre votre propre infrastructure.
Cet article vous montre comment le recours à Apache Spark dans les lakehouses résout ces difficultés en offrant un moteur unifié pour toutes vos charges de travail. Vous découvrirez comment les dernières avancées de Spark 4.2.0 et du Runtime 2.0 de Microsoft Fabric raccourcissent le délai d'obtention des analyses tout en réduisant la complexité architecturale. Nous explorerons le chemin vers une source unique de vérité, capable d'alimenter à la fois l'analytique en temps réel et une gouvernance d'entreprise solide. À la fin de ce guide, vous saurez comment préparer votre plateforme de données aux exigences de performance de 2026 et au-delà.
Comprendre la synergie : pourquoi Apache Spark définit l'ère du lakehouse
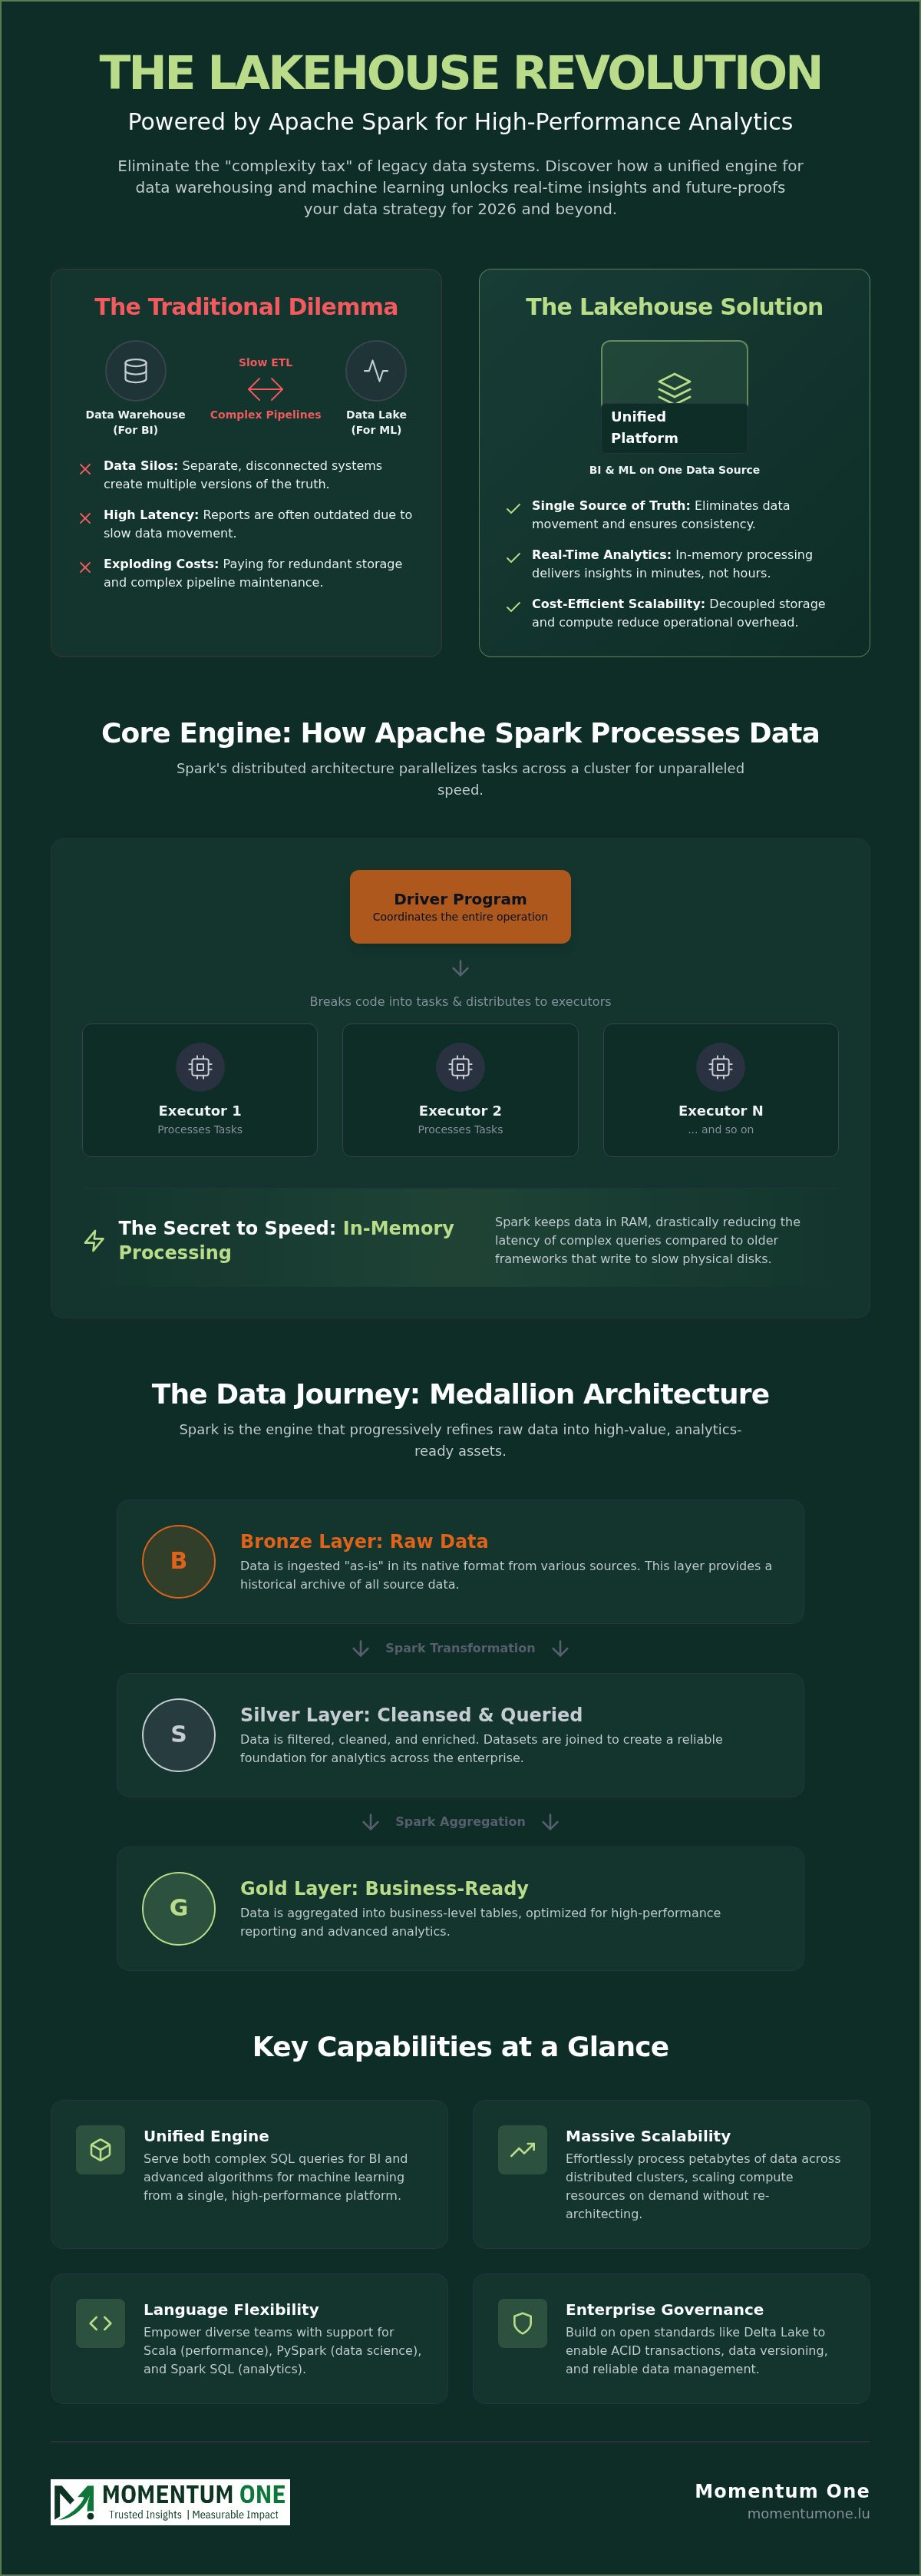
L'architecture data moderne s'éloigne des frontières rigides qui séparaient autrefois lacs et entrepôts de données. Cette convergence porte un nom : l'architecture lakehouse, un cadre conçu pour offrir la performance d'un entrepôt avec l'échelle massive d'un lac. Apache Spark en est le cœur. Moteur de calcul distribué, Spark fournit la puissance nécessaire pour traiter des pétaoctets de données sur des grappes de machines. C'est lui qui rend le lakehouse viable, en permettant d'appliquer structure et gouvernance directement à des données brutes stockées dans des formats ouverts.
D'ici 2026, la dépendance aux processus ETL rigides a laissé place à un traitement Spark plus souple, à schéma appliqué à la lecture. Cette approche vous permet de conserver la donnée dans son format natif et de ne lui appliquer une structure qu'au moment de l'analyser. En s'appuyant sur des standards ouverts comme Delta Lake et Parquet, Apache Spark dans les lakehouses garde vos données accessibles, interopérables et pérennes. Vous n'êtes pas enfermé dans un format propriétaire : vous bâtissez sur un socle compatible avec tous les outils analytiques modernes.
La fin des silos de données
Les architectures traditionnelles vous obligent souvent à déplacer la donnée entre un lac pour l'apprentissage automatique et un entrepôt pour le décisionnel. Ce mouvement est lent, coûteux et engendre plusieurs versions de la vérité. Spark supprime cette friction en servant de moteur unique aux deux usages. Que vous exécutiez une requête SQL complexe pour un rapport mensuel ou que vous entraîniez un modèle prédictif, vous travaillez sur le même jeu de données sous-jacent. Un moteur unifié est le cœur technique de l'architecture 2026 : il regroupe tous les besoins de calcul sur une seule plateforme évolutive.
L'évolutivité au service des entreprises luxembourgeoises
Pour les entreprises du Luxembourg, gérer des volumes croissants exige une plateforme qui grandit sans faire exploser les coûts. Le traitement distribué n'est plus un luxe : c'est une nécessité pour conduire efficacement des opérations d'envergure nationale. Spark y parvient en découplant stockage et calcul : vous ne payez que la puissance de traitement utilisée, pendant que vos données reposent à moindre coût dans le stockage cloud. Si vous pesez vos options, explorer la conception d'entrepôt de données et de lakehouse vous aidera à déterminer la meilleure voie pour votre infrastructure. Apache Spark dans les lakehouses offre l'appui stable nécessaire à cette transition et garde votre architecture sobre et performante.
Les mécanismes essentiels : comment Spark traite la donnée dans un lakehouse
Pour comprendre pourquoi Apache Spark dans les lakehouses offre de telles performances, il faut se pencher sur son modèle d'exécution distribué. Spark fonctionne selon une architecture maître-esclave, où un programme pilote central coordonne l'ensemble de l'opération. Ce pilote découpe votre code en tâches et les répartit entre plusieurs exécuteurs. Ces exécuteurs sont les ouvriers qui réalisent le traitement effectif sur chaque nœud de la grappe. C'est cette parallélisation qui permet à un lakehouse de traiter des téraoctets en quelques minutes plutôt qu'en quelques heures.
Le véritable secret de la rapidité de Spark tient à son traitement en mémoire. Contrairement aux cadres plus anciens qui réécrivent en permanence les données intermédiaires sur des disques lents, Spark conserve autant de données que possible en RAM. Cela réduit fortement la latence des requêtes analytiques complexes en plusieurs étapes. C'est aussi un outil très polyvalent pour des équipes variées : les ingénieurs data peuvent recourir à Scala pour des pipelines performants, les data scientists à PySpark pour l'apprentissage automatique, et les analystes à Spark SQL pour interroger les jeux de données avec une syntaxe familière. Pour maintenir de l'ordre dans ces opérations, Spark dialogue avec des couches de métadonnées comme Delta Lake ou Apache Hudi. Ces couches apportent la gouvernance nécessaire et permettent à Spark de réaliser des transactions ACID et un versionnage des données par-dessus un stockage cloud standard.
Le moteur de l'architecture en médaillon
Spark est le principal moteur employé pour mettre en œuvre l'architecture en médaillon, qui organise la donnée en couches bronze, argent et or. Dans la couche bronze, Spark ingère les données brutes « telles quelles », depuis diverses sources. Il les fait ensuite passer en couche argent en filtrant, nettoyant et joignant les jeux de données pour bâtir un socle fiable. Enfin, Spark agrège cette donnée dans la couche or, prête pour un usage métier. Spark peut par exemple ingérer des millions de signaux désordonnés issus de capteurs connectés, en retirer les doublons et les transformer en un jeu de données affiné, qui alimentera un rapport Power BI propre. Si vous êtes prêt à dépasser une donnée fragmentée, nos experts peuvent guider votre modernisation de l'architecture de données afin que chaque couche de votre lakehouse soit optimisée pour la performance.
Traitement par lots ou flux en temps réel
Les entreprises modernes ne se contentent plus de traitements nocturnes par lots. Spark Structured Streaming permet une ingestion à faible latence, qui alimente le lakehouse en quasi temps réel. L'atout de cette approche est son API unifiée : vous employez la même logique de code pour le traitement par lots historique et pour les flux en direct. Cette cohérence simplifie votre base de code et réduit le risque d'erreurs. Bien conduire ces transitions demande une solide automatisation des pipelines et des flux de données, pour que la donnée circule de façon fiable de la source à l'analyse, sans intervention manuelle. Apache Spark dans les lakehouses offre la souplesse technique nécessaire pour traiter ces charges variées sous une même bannière.
Apache Spark dans Microsoft Fabric : orchestrer l'environnement OneLake
Microsoft Fabric a profondément redéfini notre façon de travailler avec les gros volumes. Dans cet écosystème, Spark n'est pas un module complémentaire : c'est un citoyen de premier rang, conçu pour fonctionner de concert avec OneLake, souvent décrit comme le « OneDrive de la donnée ». L'un des atouts majeurs pour les équipes en 2026 est le caractère serverless de Fabric Spark. Vous n'avez plus à passer des heures à administrer des grappes ni à vous soucier d'une mise à l'échelle manuelle : vous vous concentrez sur la logique de vos transformations pendant que la plateforme gère automatiquement les ressources de calcul.
La magie opère vraiment lorsque Apache Spark dans les lakehouses rejoint la couche de présentation. En traitant et en stockant la donnée au format Delta Parquet, vous activez le mode « Direct Lake » dans Power BI. Le moteur de reporting interroge alors directement les données dans OneLake, sans déplacement traditionnel ni actualisation chronophage. Le fossé entre donnée brute et analyse métier est ainsi comblé, avec des performances inférieures à la seconde sur d'immenses jeux de données, jusque-là trop volumineux ou trop complexes pour être traités sans latence.
Notebooks Spark ou Data Factory
Choisir entre notebooks Spark et pipelines Data Factory est une décision stratégique, qui met en balance la puissance du code et la rapidité du low-code. Les notebooks sont le choix privilégié des travaux d'ingénierie complexes, qui réclament le contrôle fin de Python, Scala ou R. Ils permettent de maîtriser les techniques d'ingénierie de données modernes, comme l'intégration de bibliothèques personnalisées ou des logiques de nettoyage élaborées. Data Factory, à l'inverse, offre une interface visuelle pour une ingestion et une orchestration simples. Pour les organisations qui préparent une bascule, nos services de migration et modernisation Fabric vous aident à trouver le juste équilibre entre ces outils, afin de maximiser la productivité des développeurs sans perdre la maîtrise de votre architecture.
Les bénéfices de l'intégration à OneLake
OneLake est un lac logique unique et unifié pour toute l'organisation. Grâce aux « raccourcis », Spark peut traiter des données situées dans différents emplacements ou comptes cloud sans dupliquer les fichiers physiques. Cette approche réduit fortement les coûts de stockage et limite le risque de dérive des données. Elle est particulièrement précieuse pour les entreprises luxembourgeoises, qui doivent respecter une stricte souveraineté des données tout en profitant d'une analytique à l'échelle mondiale. Une gouvernance unifiée garantit que les règles de sécurité appliquées au niveau du lac se propagent sur tout le cycle de vie. Si vous cherchez une approche structurée de cette transition, nos services de migration vers Microsoft Fabric proposent une feuille de route complète pour 2026. Recourir à Apache Spark dans les lakehouses au sein de l'environnement Fabric garantit que vos données ne sont pas seulement stockées : elles sont orchestrées au service d'une croissance durable.
Optimiser les performances de Spark pour une analytique lakehouse évolutive
Une objection fréquente en comité de direction est que Spark serait trop coûteux ou trop lent pour des charges d'entreprise. Cette perception vient généralement d'une mauvaise configuration, non d'une limite du moteur. Les coûts d'exploitation élevés résultent souvent du « data shuffling », ce déplacement de données sur le réseau entre les nœuds d'une grappe. Comme les entrées-sorties réseau sont bien plus lentes que le traitement en mémoire, limiter ces brassages est le premier pas vers l'efficacité. En recourant aux jointures par diffusion pour les petites tables et en partitionnant correctement vos données, vous réduisez fortement cette charge. En 2026, exploiter Apache Spark dans les lakehouses suppose une supervision proactive : l'interface Spark reste votre meilleure alliée pour repérer ces goulets avant qu'ils ne pèsent sur votre budget.
Le dimensionnement des partitions est un autre facteur décisif. Des partitions trop petites vous exposent au « problème des petits fichiers », où la gestion des métadonnées coûte plus cher que le traitement lui-même. Des partitions trop grandes provoquent à l'inverse une pression mémoire et un déversement sur disque. Nous recommandons généralement une taille de fichier cible comprise entre 128 Mo et 1 Go, selon la charge et la configuration de la grappe. Ce juste équilibre permet à chaque exécuteur de travailler à plein régime, sans être ni sous-alimenté ni submergé par des tâches administratives.
CBO et exécution adaptative des requêtes (AQE)
Les versions modernes de Spark, dont la série 4.x présente dans le Runtime 2.0 de Microsoft Fabric, embarquent des couches d'optimisation avancées : optimisation fondée sur les coûts (CBO) et exécution adaptative des requêtes (AQE). Le CBO s'appuie sur les statistiques de tables pour choisir les stratégies de jointure les plus efficaces dans votre couche or, avant même le lancement de la requête. L'AQE va plus loin en réoptimisant les plans à l'exécution, en fonction de la taille réelle des données traitées. L'exécution adaptative améliore nettement l'utilisation des ressources : elle fusionne automatiquement les partitions de brassage et absorbe les déséquilibres de données sans modification manuelle du code.
Compactage de fichiers et Z-Ordering
Même le meilleur code ne compense pas une couche de stockage fragmentée. Le « problème des petits fichiers » est un tueur de performance dans tout environnement lakehouse. Pour y remédier, effectuez régulièrement un compactage à l'aide de la commande « OPTIMIZE » de Delta Lake. Dans l'écosystème Microsoft Fabric, le « V-Order » accélère encore la lecture en réorganisant les données au sein des fichiers Parquet pour un parcours plus rapide. Appliquer le Z-Ordering aux colonnes fréquemment filtrées permet à Spark d'ignorer entièrement les données non pertinentes, ce qui réduit les coûts d'entrées-sorties et accélère vos rapports. Si vous peinez à maîtriser vos coûts cloud, nos services d'optimisation des espaces de travail et des capacités vous apportent la supervision technique nécessaire à un environnement sobre et rapide. Laissez-nous affiner votre conception de lakehouse pour une efficacité maximale dès le premier jour.
Déployer une stratégie lakehouse portée par Spark avec Momentum One
Passer de la théorie technique au déploiement réel demande un appui stable et une trajectoire claire. Comprendre les mécanismes d'Apache Spark dans les lakehouses est indispensable, mais la mise en œuvre doit servir vos objectifs métier pour réussir. Microsoft Solutions Partner certifié établi au Luxembourg, Momentum One est votre stratège fiable et votre facilitateur expert. Nous ne construisons pas seulement des pipelines : nous concevons des environnements où Spark sert de moteur fondateur à une « source unique de vérité ». Notre approche garantit une architecture sûre, évolutive et pleinement intégrée à vos cadres de gouvernance existants.
Nos services managés assurent la supervision technique continue qui maintient les performances de votre environnement à mesure que vos données grandissent. Nous privilégions des mises en œuvre orientées résultats, qui réduisent la complexité architecturale tout en améliorant l'exactitude de vos rapports. En travaillant avec nous, vous accédez à une expertise technique de haut niveau, sans la froideur d'un conseil corporate classique. Nous nous engageons pleinement dans votre parcours, afin que chaque transformation portée par Spark serve votre croissance et votre efficacité opérationnelle.
De l'entrepôt hérité au lakehouse moderne
Beaucoup d'entreprises luxembourgeoises mènent aujourd'hui la transition de systèmes hérités rigides et cloisonnés vers des environnements fluides et performants. C'est souvent pendant cette phase de migration que surviennent les écueils les plus lourds : grappes de calcul mal configurées, sécurité des données fragmentée. Pour combler le déficit de compétences internes, nous proposons des formations data fabric en entreprise. Ces ateliers sur mesure permettent à vos équipes techniques de maîtriser les subtilités du développement Spark dans l'écosystème Microsoft Fabric. Nous misons sur une pédagogie concrète, orientée code, qui transforme les obstacles techniques en occasions de croissance.
Un partenariat stratégique pour durer
Choisir un cabinet à taille humaine comme Momentum One, c'est bénéficier d'une agilité et d'un engagement que les grands groupes internationaux peinent souvent à égaler. Nous privilégions un partenariat attentif, qui passe méthodiquement des grandes promesses aux capacités techniques précises répondant à vos difficultés réelles. Notre travail de modernisation de l'architecture de données garantit que vos transformations portées par Spark alimentent directement un décisionnel de haut niveau, grâce à un conseil et une gouvernance Power BI experts. Si vous êtes prêt à consolider votre stratégie data pour 2026, vous pouvez planifier une revue d'architecture lakehouse dès aujourd'hui. Nous vous aiderons à affiner votre usage d'Apache Spark dans les lakehouses, pour un délai d'analyse plus court et une complexité durablement réduite.
Bâtir un avenir data résilient
Le passage à une plateforme de données unifiée n'est plus un luxe pour les entreprises en croissance : c'est une nécessité stratégique. En intégrant Apache Spark dans les lakehouses, vous avez vu comment supprimer enfin la friction entre d'immenses lacs de données et des entrepôts performants. Cette synergie fournit le socle technique nécessaire pour alimenter l'analytique en temps réel tout en maintenant une gouvernance stricte dans toute l'organisation. Que vous optimisiez des partitions de brassage ou orchestriez des charges complexes dans Microsoft Fabric, l'objectif reste le même : des analyses plus rapides et une complexité architecturale nettement réduite.
Momentum One est là pour être votre appui stable dans ce paysage en mouvement. Microsoft Solutions Partner certifié présent sur tout le territoire luxembourgeois, nous sommes spécialistes du réglage expert des performances Spark et des mises en œuvre orientées résultats. Nous n'apportons pas que des correctifs techniques : nous bâtissons des partenariats durables, qui simplifient votre marche vers une source unique de vérité. Il est temps de cesser de lutter contre votre infrastructure pour en faire un moteur de croissance. Modernisez votre architecture de données avec une conception lakehouse sur mesure et préparez votre entreprise à réussir en 2026 et au-delà.
Questions Fréquemment Posées
Quelle différence entre Apache Spark et le SQL traditionnel dans un lakehouse ?
Spark est un moteur de calcul distribué polyvalent, tandis que les moteurs SQL traditionnels sont d'abord pensés pour interroger des données structurées. Dans un lakehouse, Spark prend en charge les transformations non linéaires et l'apprentissage automatique, qui dépassent les capacités du SQL standard. Recourir à Apache Spark dans les lakehouses vous permet de traiter à grande échelle des données non structurées et des logiques complexes. Le SQL excelle pour le reporting ; Spark apporte la souplesse nécessaire à une ingénierie de données et à une analytique avancées sur des jeux de données variés.
Apache Spark est-il indispensable pour un lakehouse de petite taille ?
Il n'est pas strictement indispensable sur de petits volumes, mais il pose un socle qui ne cédera pas quand vos données grandiront. Vous pouvez traiter des charges modestes avec des dataflows Power BI ou du SQL classique ; Spark vous évite toutefois une refonte complète plus tard. Il s'agit de pérenniser votre plateforme pour que vos équipes absorbent des volumes d'envergure nationale sans dette technique. Commencer avec Spark facilite la transition à mesure que vos besoins d'entreprise se développent.
Comment Microsoft Fabric simplifie-t-il l'administration d'Apache Spark ?
Microsoft Fabric supprime la charge de l'administration manuelle d'infrastructure en offrant un environnement entièrement serverless. Vous n'avez ni grappes à configurer ni machines virtuelles à gérer : la plateforme ajuste automatiquement la mise à l'échelle selon vos charges. Avec l'arrivée du Runtime 2.0 et de Spark 4.1 en 2026, vous bénéficiez de performances optimisées dès la mise en service. Vos équipes peuvent ainsi se consacrer à la création de valeur plutôt qu'à des tâches administratives fastidieuses.
Peut-on utiliser Apache Spark pour l'ingestion en temps réel dans un lakehouse ?
Oui : Spark Structured Streaming est la référence de l'ingestion à faible latence. Il vous permet de traiter des flux en direct avec la même logique que vos traitements par lots. Cette approche unifiée simplifie votre cycle de développement et garde votre couche or à jour. Intégrer Apache Spark dans les lakehouses pour l'ingestion en temps réel aide votre entreprise à réagir plus vite aux évolutions du marché, en donnant un accès quasi immédiat à des données fraîches et exploitables.
Quelles sont les implications financières de Spark dans un lakehouse cloud ?
Les coûts sont généralement liés à la capacité de calcul et à sa durée, plutôt qu'à des investissements matériels fixes. Le découplage du stockage et du calcul fait que vous ne payez le traitement que lorsque vos travaux Spark tournent. Une mauvaise configuration peut toutefois engendrer des dépenses inutiles, par excès de brassage de données ou par ressources inutilisées. Nous recommandons de surveiller de près l'usage de votre capacité Fabric, afin que vos pipelines restent économiques tout en offrant les performances qu'exigent vos charges analytiques.
Faut-il connaître Python ou Scala pour utiliser Spark dans un lakehouse ?
Nul besoin d'être développeur pour profiter de la puissance de Spark. Spark SQL permet aux analystes de réaliser des transformations complexes avec la syntaxe SQL qu'ils connaissent déjà. PySpark et Scala offrent un contrôle plus fin pour l'ingénierie spécialisée, mais les options low-code de Microsoft Fabric rendent Spark accessible à un public bien plus large. Cette souplesse permet à toute votre équipe de contribuer à l'architecture lakehouse, quel que soit son bagage technique.
Comment Spark garantit-il la qualité des données dans l'architecture en médaillon ?
Spark joue le rôle de gardien de la qualité en imposant les schémas et en réalisant des transactions ACID à chaque étape. Lors du passage de la couche bronze à la couche argent, les travaux Spark éliminent les doublons et corrigent les types de données pour bâtir un socle propre. Ce nettoyage automatisé prévient les scénarios de « marécage de données ». Lorsque la donnée atteint la couche or, elle est affinée et validée : une source de vérité fiable pour vos rapports Power BI critiques.
Quel est le rôle de Delta Lake lorsqu'on utilise Apache Spark ?
Delta Lake fournit le cadre de stockage grâce auquel Spark gère la donnée avec la fiabilité d'un entrepôt. Il ajoute une couche de métadonnées versionnées par-dessus vos fichiers Parquet, ce qui autorise le « voyage dans le temps » et les journaux d'audit. Spark dialogue avec cette couche pour éviter toute corruption lors de lectures et d'écritures concurrentes. Cette combinaison transforme un lac de données classique en un lakehouse robuste, capable de soutenir une gouvernance d'entreprise et des requêtes analytiques rapides.