Optimisation des modèles sémantiques : améliorer les performances de Power BI et Microsoft Fabric
Un modèle sémantique bien optimisé est la clé d'une analytique rapide, évolutive et fiable. Ce guide couvre la conception du modèle, l'optimisation DAX, la gestion des relations, les stratégies de stockage et les techniques d'optimisation des performances pour Power BI et Microsoft Fabric, au service d'un reporting à l'échelle de l'entreprise et prêt pour l'IA.
- Comprenez la « boucle performance-confiance » et comment des rapports lents sapent directement la source unique de vérité de votre organisation.
- Apprenez à équilibrer stockage et calcul en exploitant le stockage en colonnes du moteur VertiPaq pour une efficacité maximale.
- Adoptez une architecture en schéma en étoile pour simplifier vos mesures DAX et éliminer les goulets d'étranglement propres aux modèles en flocon complexes.
- Suivez une feuille de route méthodique d'optimisation du modèle sémantique à l'aide d'outils de diagnostic professionnels comme DAX Studio et l'analyseur de performances.
- Mesurez les bénéfices d'un audit de performance externe pour stabiliser vos coûts Microsoft Fabric et préparer votre architecture de données à la croissance.
Vos données d'entreprise ne valent que par la vitesse à laquelle vos équipes peuvent réellement les exploiter. Si vos utilisateurs attendent plus de trois secondes l'affichage d'un visuel, ils ne perdent pas seulement du temps : ils perdent confiance dans la donnée elle-même. Beaucoup d'organisations constatent que la croissance de leurs données s'accompagne d'une hausse de leurs frais de capacité Microsoft Fabric, qui démarrent autour de 263 € par mois pour un SKU F2 en paiement à l'usage. C'est un cycle frustrant, où les performances baissent pendant que les coûts grimpent. L'optimisation du modèle sémantique est le levier décisif à actionner pour reprendre la main sur votre environnement et cesser de payer pour de l'inefficacité.
Nous savons que gérer des mesures DAX complexes et des jeux de données massifs peut ressembler à un combat permanent. Vous méritez des temps de réponse inférieurs à la seconde et une architecture évolutive qui ne fasse pas exploser le budget. Cet article trace une feuille de route claire pour maîtriser les piliers techniques et stratégiques de l' optimisation du modèle sémantique. Nous verrons comment réduire la taille de vos modèles, limiter les coûts de stockage et bâtir des déploiements Power BI et Fabric prêts pour votre croissance future. Nous irons des grands principes de performance jusqu'aux gestes techniques précis qui transforment vos données en un actif sobre et rapide.
Pourquoi l' optimisation du modèle sémantique est déterminante pour la scalabilité de l'entreprise
L'optimisation du modèle sémantique est le travail rigoureux d'affinage des structures de données, des relations et des calculs DAX afin de maximiser la vitesse des requêtes et l'efficacité des ressources. Elle garantit avant tout que votre modèle de données sémantique joue le rôle d'un pont performant entre données brutes et analyses métier. Lorsque les rapports traînent, les utilisateurs entrent dans ce que nous appelons la boucle performance-confiance. Quelques secondes d'attente suffisent souvent pour que les parties prenantes abandonnent le tableau de bord officiel au profit de fichiers Excel locaux. Ce glissement crée des silos fragmentés et détruit la source unique de vérité que vous avez patiemment construite. Une optimisation efficace est l'un des piliers du conseil et gouvernance Power BI, car elle garantit que votre architecture reste soutenable à mesure que vos volumes augmentent.
Le coût de l'inefficacité en 2026
Dans l'écosystème Microsoft Fabric actuel, l'inefficacité a un prix direct. Des modèles non optimisés consomment un excès d'unités de calcul (CU), ce qui fait vite grimper votre dépense mensuelle. Avec une capacité Fabric démarrant autour de 263 € par mois pour un SKU F2 en paiement à l'usage, chaque cycle gaspillé pèse sur vos résultats. Des modèles volumineux et alourdis entraînent aussi des actualisations lentes et une latence accrue, qui empêchent la décision en temps réel. L'efficacité de Direct Lake dépend fondamentalement des stratégies de compression et de partitionnement appliquées lors de la conception du modèle.
Expérience utilisateur et adoption de la donnée
L'adhésion des dirigeants tient à la rapidité. Un tableau de bord qui ne se charge pas en trois secondes est souvent perçu comme cassé ou peu fiable. Ces trois secondes constituent un seuil psychologique pour la plupart des utilisateurs professionnels. Des temps de réponse inférieurs à la seconde ne sont pas un luxe technique : ils sont le minimum pour une forte adoption. En donnant la priorité à l' optimisation du modèle sémantique, vous supprimez la friction qui empêche vos équipes d'explorer les données en profondeur. Dans des environnements complexes, un modèle sobre réduit également le risque d'erreurs de calcul, ce qui améliore l'exactitude et rend les séances de travail stratégiques plus sereines.
Maîtriser ces optimisations permet à vos équipes de quitter le dépannage réactif pour une véritable stratégie. Il s'agit de bâtir un socle capable de servir des milliers d'utilisateurs sans envolée équivalente des coûts d'infrastructure. En explorant le moteur qui anime ces modèles, vous verrez comment des choix de conception précis influencent directement ces résultats métier.
Comprendre le moteur : optimiser le stockage ou le calcul
Une optimisation du modèle sémantique efficace suppose de regarder sous le capot, du côté du moteur VertiPaq. Ce moteur de stockage en colonnes est la force qui anime Power BI et Microsoft Fabric : il compresse et interroge des jeux de données massifs à très grande vitesse. La performance ne se résume toutefois pas à la taille des fichiers. Nous distinguons les « données au repos », c'est-à-dire l'empreinte de stockage physique, et les « données en mouvement », qui mobilisent des cycles CPU pour les calculs. On croit souvent à tort qu'un petit modèle est forcément rapide. Un jeu de données minuscule peut rester poussif si la logique DAX est mal structurée. Votre objectif premier est de réduire la cardinalité, ce qui améliore directement la compression et la récupération des données par le moteur.
Optimiser la couche de stockage
Réduire la cardinalité des colonnes est le geste le plus efficace pour alléger votre modèle et améliorer les temps de réponse. Chaque valeur unique d'une colonne exige une entrée de dictionnaire ; les colonnes à forte cardinalité, comme des GUID ou des horodatages à la milliseconde, gonflent ce dictionnaire et ralentissent le moteur. Supprimez sans hésiter les colonnes inutilisées et désactivez les « hiérarchies d'attributs » pour les champs qui n'en ont pas besoin. Ces hiérarchies invisibles peuvent doubler la taille de votre modèle sans apporter la moindre valeur analytique. Si vous préparez une migration et modernisation Fabric, ce nettoyage du stockage est une première étape essentielle pour que votre nouvel environnement reste économique.
La couche de calcul et l'efficacité DAX
Lorsqu'une requête s'exécute, le moteur de formules (FE) et le moteur de stockage (SE) travaillent de concert. Le SE est multithread et remarquablement rapide pour récupérer les données, tandis que le FE traite la logique complexe mais reste souvent monothread. Des fonctions DAX « coûteuses », comme certains itérateurs ou filtres complexes, obligent le FE à faire le gros du travail et créent un goulet d'étranglement qui exaspère les utilisateurs. Vous trouverez une explication technique détaillée des modèles sémantiques Power BI pour comprendre l'interaction de ces moteurs selon les modes de stockage. Le schéma en étoile est l'architecture supérieure pour VertiPaq, car il réduit au minimum le travail de jointure et de filtrage demandé aux moteurs.
En conjuguant réduction du stockage et logique de calcul sobre, vous obtenez un modèle à la fois compact et réactif. Cette approche à deux niveaux de l' optimisation du modèle sémantique maintient vos rapports rapides même lorsque vos données grossissent. Dans la section suivante, nous entrerons dans les schémas de conception qui vous évitent les pièges de performance les plus courants.
Performance DAX ou conception du modèle : où se cachent les vrais goulets d'étranglement
Créer un « jeu de données de référence » demande plus que de la maîtrise technique : cela exige un équilibre stratégique entre architecture propre et code sobre. Nous voyons souvent des équipes tenter de « réparer » un modèle désordonné à coups de mesures DAX de plus en plus complexes. C'est un piège classique. Aussi puissant soit-il, le DAX ne peut compenser un socle dépourvu d'intégrité structurelle. Dans une démarche d' optimisation du modèle sémantique, c'est le modèle lui-même qui doit faire le gros du travail, afin que votre DAX reste simple, lisible et rapide. Si vos mesures deviennent ingérables, il est sans doute temps de revoir votre stratégie de modélisation de données et optimisation DAX pour vérifier que votre architecture ne joue pas contre vous.
Le choix entre un schéma en flocon et un schéma en étoile illustre parfaitement ce principe. Les schémas en flocon peuvent sembler plus normalisés du point de vue d'une base de données traditionnelle, mais le schéma en étoile reste le vainqueur incontesté pour les modèles sémantiques. Il réduit le nombre de jointures que le moteur VertiPaq doit exécuter, ce qui se traduit directement par des temps de réponse plus courts pour vos utilisateurs. En aplatissant les dimensions et en établissant des relations claires, vous simplifiez le chemin du moteur vers la donnée et réduisez fortement la charge CPU de chaque visuel.
Modélisation avancée pour une BI qui passe à l'échelle
La scalabilité dépend souvent de votre traitement des relations et des données calculées. Les filtres bidirectionnels, par exemple, servent fréquemment à répondre à un besoin de reporting précis, mais ils introduisent de l'ambiguïté et peuvent dégrader sérieusement les performances. Ils obligent le moteur à évaluer les filtres dans plusieurs directions, ce qui produit souvent des résultats inattendus et des affichages plus lents. Soyez également attentif à l'endroit où vous placez votre logique. Les colonnes calculées sont traitées lors de l'actualisation et consomment de la mémoire, tandis que les mesures sont calculées à la volée et consomment du CPU. Trouver le bon équilibre est essentiel. Pour comprendre l'incidence de vos choix de socle, consultez notre guide sur la conception Data Lakehouse ou entrepôt de données.
Anti-modèles DAX à éviter
Même avec un modèle irréprochable, certaines habitudes DAX ruinent les performances. L'usage inutile de la fonction FILTER() figure parmi les fautes les plus fréquentes. Employer FILTER() sur une grande table plutôt qu'un simple filtre booléen dans CALCULATE() force le moteur à parcourir chaque ligne. Ce traitement ligne à ligne est bien plus lent que le filtrage par colonne pour lequel le moteur a été conçu. Parmi les autres anti-modèles :
- IFERROR() et FORMAT() : ces fonctions empêchent souvent le moteur d'appliquer ses optimisations internes les plus efficaces et renvoient les calculs vers le moteur de formules, plus lent.
- Itérateurs en excès : des fonctions comme SUMX() ou AVERAGEX() sont puissantes, mais doivent être employées avec parcimonie sur des colonnes à forte cardinalité.
- Manipulations de chaînes complexes : effectuer de lourds traitements de texte dans des mesures DAX plutôt que dans la couche de transformation en amont.
L'objectif de l' optimisation du modèle sémantique est de convertir ces mesures complexes et coûteuses à maintenir en une logique plus simple, portée par le modèle. En déplaçant la complexité du code vers la conception, vous obtenez un système plus facile à maintenir et bien plus réactif pour vos utilisateurs finaux.
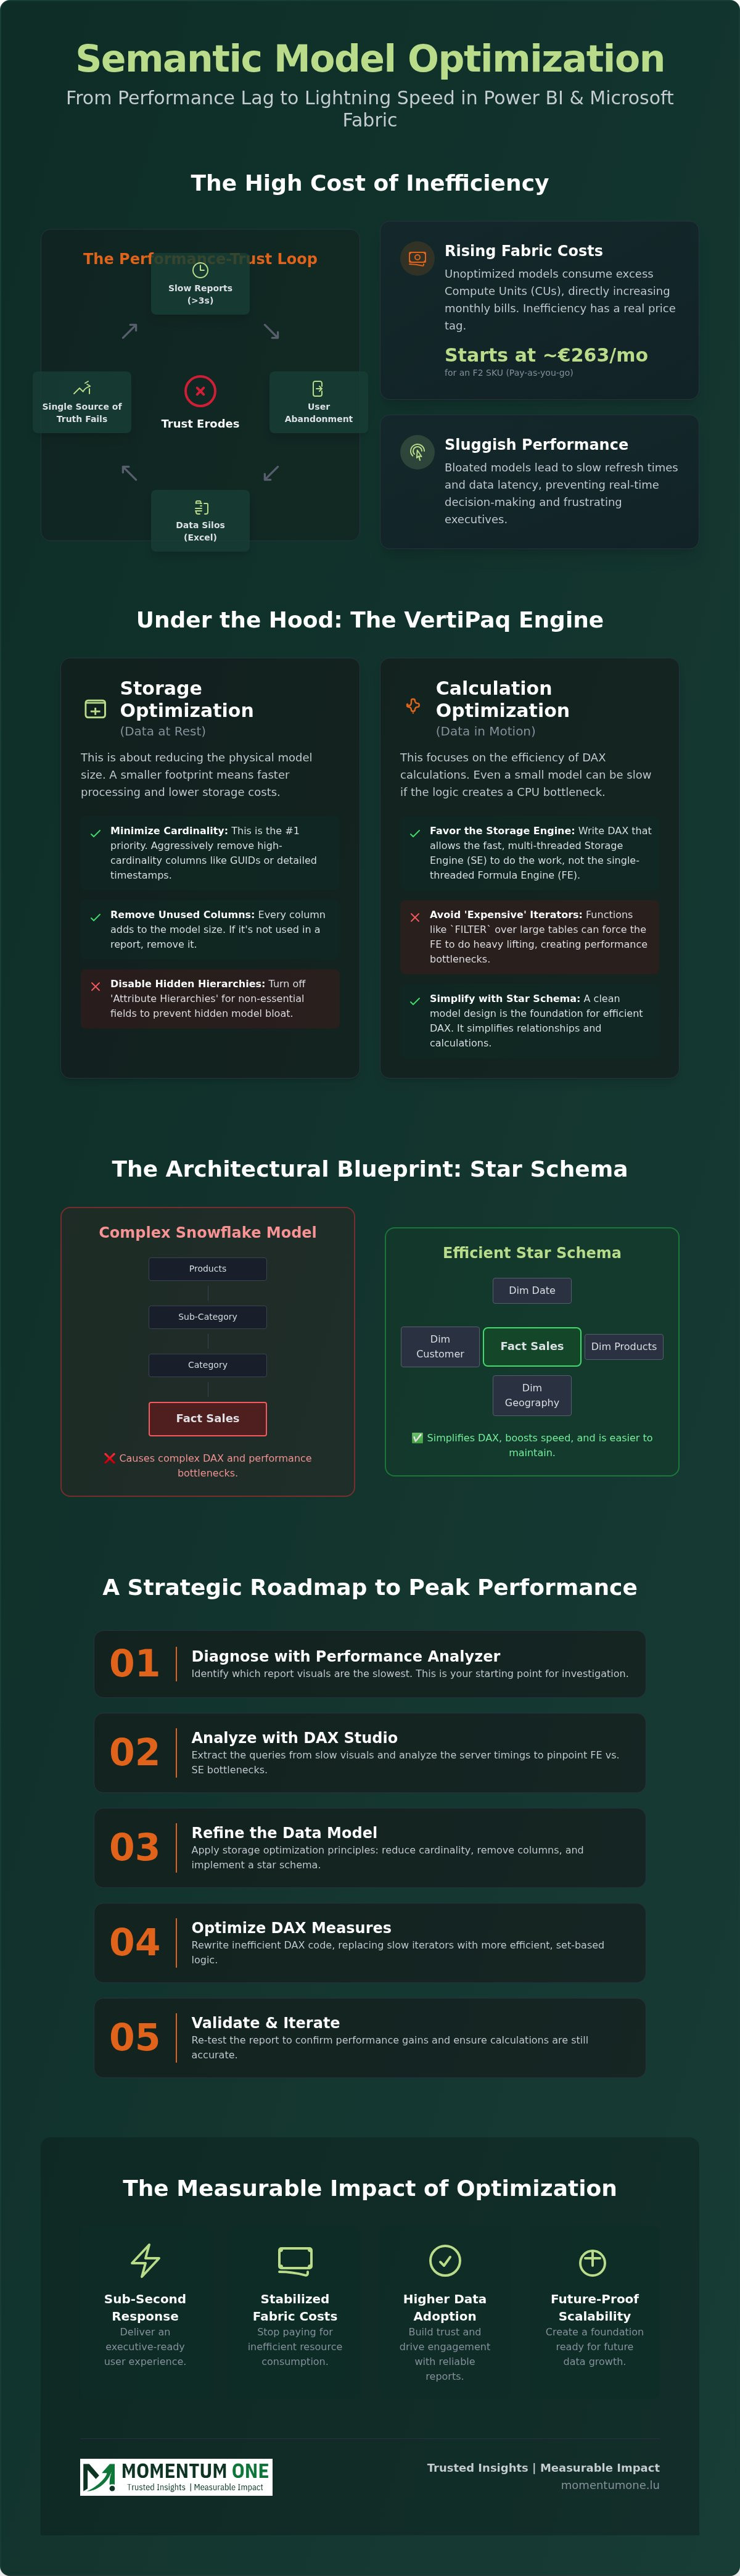
Une feuille de route stratégique pour optimiser vos modèles Power BI et Fabric
Une optimisation du modèle sémantique réussie suit un cheminement de diagnostic structuré plutôt qu'une logique d'essais successifs. Nous recommandons un cycle en cinq étapes pour garder vos données sobres et réactives. D'abord, établissez une base de référence avec l'analyseur de performances Power BI afin de repérer les visuels lents. Ensuite, menez une analyse approfondie avec DAX Studio pour déterminer si le goulet se situe dans le moteur de formules ou dans le moteur de stockage. Troisièmement, utilisez Tabular Editor et son Best Practice Analyzer pour automatiser la suppression des objets inutilisés et faire respecter vos standards de modélisation. Quatrièmement, pour les jeux de données massifs, mettez en place des agrégations définies par l'utilisateur afin de pré-résumer les données et d'alléger vos tables de faits. Enfin, instaurez un cycle de supervision continue via l'application Fabric Capacity Metrics pour suivre la consommation en temps réel et prévenir les envolées de coûts.
La boîte à outils indispensable
C'est la maîtrise des bons outils qui distingue un modèle performant d'un modèle ordinaire. DAX Studio est votre principal poste de diagnostic. En analysant les temps serveur, vous voyez si vos requêtes passent trop de temps dans le moteur de formules (FE, monothread) ou dans le moteur de stockage (SE, multithread). Si le FE est en cause, votre logique DAX demande sans doute à être simplifiée. Si le SE est lent, le problème vient de la conception du modèle ou de la cardinalité. VertiPaq Analyzer vous aide à repérer les colonnes les plus « lourdes » par taille de dictionnaire ou cardinalité, et montre précisément où le stockage est gaspillé. Pour la gouvernance à long terme, nous utilisons des scripts Tabular Editor 3 afin d'automatiser les contrôles qualité et de garantir que chaque nouvelle mesure respecte vos standards de performance avant d'atteindre la production.
L'optimisation à l'ère de Microsoft Fabric
Microsoft Fabric ouvre des possibilités architecturales qui changent la donne côté performance. Le mode Direct Lake vous permet par exemple d'interroger les données directement depuis OneLake, sans import traditionnel ni latence de DirectQuery. Ce mode offre la vitesse du mode Import et le caractère temps réel de DirectQuery, à condition que vos fichiers Delta soient correctement optimisés et compressés. Gérer le stockage OneLake est tout aussi déterminant pour éviter la dispersion des données et les modèles redondants qui gonflent vos coûts de capacité. Si vous souhaitez moderniser votre socle, nos services de migration Microsoft Fabric offrent un cadre dédié pour faire évoluer vos modèles hérités vers cet environnement performant. Pour les équipes qui ont besoin d'un accompagnement continu, nos services d'optimisation managés apportent la main sûre qui maintient des coûts de capacité prévisibles et des rapports constamment rapides.
Un partenariat pour la performance : services d'optimisation managés
Maintenir un environnement de données performant est un engagement à plein temps. Les équipes internes se retrouvent souvent submergées par les demandes de rapports urgentes et la maintenance des pipelines, sans marge pour le travail technique de fond qu'exige une optimisation du modèle sémantique continue. Le réglage des performances n'est pas une tâche ponctuelle : c'est un cycle permanent de supervision et d'affinage. Sans suivi dédié, de petites inefficacités du DAX ou de la conception s'accumulent avec le temps. Cela conduit à la hausse des coûts Fabric et aux lenteurs qui exaspèrent les utilisateurs et grèvent les budgets. S'associer à un spécialiste externe apporte le regard extérieur nécessaire pour repérer des goulets d'étranglement qu'un œil interne laisse souvent passer. Nos services managés Power BI apportent cette stabilité de long terme et font passer votre organisation des correctifs réactifs à une excellence durable.
L'approche de Momentum One repose sur la précision technique et le partenariat stratégique. Nous ne traitons pas seulement les symptômes d'un rapport lent : nous refondons l'architecture sous-jacente pour atteindre une efficacité maximale. Notre démarche va d'un examen rigoureux de la structure de votre entrepôt de données à une refonte ciblée du DAX, afin que chaque calcul soit le plus sobre possible. Cette posture proactive protège votre investissement et fait de votre plateforme un actif fiable, quelle que soit la croissance de vos volumes.
Le cadre de performance Momentum One
Nous appliquons une revue à 360 degrés qui examine conjointement gouvernance, architecture et code. Pour les entreprises luxembourgeoises engagées dans des migrations Fabric complexes, nous sommes la main sûre qui accompagne le passage de systèmes hérités à un socle moderne et optimisé. Nous croyons aussi à l'autonomie de vos équipes. Grâce à une formation Power BI en entreprise sur mesure, nous aidons vos développeurs à intégrer ces bonnes pratiques orientées performance. Les problèmes sont ainsi évités à la source et le besoin de dépannage permanent diminue. Notre objectif est de bâtir un socle évolutif qui soutienne votre croissance sans dette technique.
Les prochaines étapes pour votre environnement de données
Passer du dépannage réactif à une gestion proactive de la performance est un virage stratégique. Il commence par un audit technique complet de vos modèles sémantiques existants, afin d'établir une base de référence claire. Nous cartographions votre consommation actuelle de ressources et vous remettons un plan d'action pour atteindre des temps de réponse inférieurs à la seconde. Cet audit est la première étape vers la maîtrise de vos coûts de capacité et le retour de la confiance des utilisateurs. Si vous êtes prêt à stabiliser votre environnement et à libérer tout le potentiel de votre architecture, vous pouvez réserver une revue de performance avec Momentum One pour engager votre marche vers l'efficacité maximale.
Pérennisez votre architecture de données
Atteindre des temps de réponse inférieurs à la seconde n'est pas qu'un objectif technique : il s'agit de faire en sorte que votre entreprise avance aussi vite que ses données. Nous avons vu comment un schéma en étoile solide et une logique DAX sobre forment le socle d'un environnement évolutif. En donnant la priorité à l' optimisation du modèle sémantique, vous ne réduisez pas seulement vos coûts de capacité Microsoft Fabric : vous rétablissez la confiance de vos utilisateurs dans leurs tableaux de bord quotidiens. Maintenir ce niveau de performance exige une discipline appliquée aux couches de stockage comme de calcul.
Microsoft Solutions Partner certifié et cabinet de conseil stratégique établi au Luxembourg, Momentum One transforme des obstacles data complexes en opportunités maîtrisées. Nos experts de l'optimisation DAX sont prêts à auditer votre environnement et à vous faire passer du dépannage réactif à une stratégie proactive, tournée vers la croissance. Nous veillons à ce que votre architecture soutienne vos ambitions sans le poids de la dette technique. Prêt à mesurer la différence ? Optimisez vos performances Power BI avec Momentum One et faites en sorte que vos données d'entreprise restent rapides, évolutives et économiques. Votre marche vers une culture data plus efficace commence par un seul geste stratégique.
Questions Fréquemment Posées
Quelle différence entre un modèle sémantique et un jeu de données ?
Le modèle sémantique est le nouveau nom de ce que l'on appelait auparavant un jeu de données dans Power BI. Microsoft a changé la dénomination pour mieux décrire la logique métier, les relations et les mesures DAX qui vivent dans le modèle. Il fait office de source unique de vérité pour votre reporting, que vous utilisiez Power BI Desktop ou l'écosystème Microsoft Fabric.
Comment savoir si mon rapport Power BI est lent à cause du DAX ou du modèle ?
Utilisez l'analyseur de performances Power BI pour isoler la cause. Si le temps de « requête DAX » est élevé, le goulet d'étranglement se situe probablement dans vos mesures ou dans la complexité de vos relations. Si le temps d'« affichage du visuel » est élevé, le problème vient sans doute du nombre de visuels sur la page. DAX Studio permet ensuite de préciser si le délai provient du moteur de formules ou du moteur de stockage.
Un modèle sémantique volumineux peut-il être rapide ?
Oui, un modèle volumineux peut atteindre des temps de réponse inférieurs à la seconde s'il a été conçu dans une logique d'optimisation du modèle sémantique. En adoptant un schéma en étoile et en réduisant la cardinalité des colonnes, vous permettez au moteur VertiPaq de compresser efficacement les données. Le moteur peut alors parcourir des millions de lignes en quelques millisecondes, ce qui prouve que l'efficacité compte davantage que le volume total.
Quelle est la taille maximale d'un modèle sémantique Power BI en 2026 ?
En 2026, un modèle sémantique dans un espace de travail Pro est limité à 1 Go. Avec Microsoft Fabric ou Power BI Premium, vous pouvez activer le « format de stockage des grands modèles sémantiques » pour dépasser cette limite, votre seule contrainte devenant la mémoire de votre capacité. La limite de chargement d'un fichier Power BI Desktop reste de 10 Go, mais la taille en mémoire peut être bien supérieure dans un environnement cloud.
À quelle fréquence faut-il optimiser son modèle sémantique ?
L'optimisation doit faire partie intégrante de votre gouvernance des données plutôt que d'être une tâche ponctuelle. Nous recommandons une revue technique chaque trimestre, ainsi qu'après toute évolution majeure de vos sources de données. Une optimisation régulière du modèle sémantique évite l'accumulation de dette technique et empêche vos coûts de capacité Microsoft Fabric de s'envoler à mesure que vos données grossissent.
Microsoft Fabric exige-t-il des techniques d'optimisation différentes de Power BI ?
Les principes fondamentaux sont les mêmes, mais Fabric introduit le mode Direct Lake, qui demande une optimisation spécifique des fichiers Delta dans OneLake. Vous devrez suivre la consommation d'unités de calcul (CU) de plus près que dans Power BI traditionnel. Les bonnes pratiques DAX restent valables, mais votre gestion du stockage et des partitions dans le lakehouse devient un élément déterminant de l'équation de performance.
Quels sont les meilleurs outils d'optimisation du modèle sémantique ?
La boîte à outils de référence comprend DAX Studio, VertiPaq Analyzer et Tabular Editor. DAX Studio est indispensable pour profiler la vitesse des requêtes, tandis que VertiPaq Analyzer vous aide à repérer les colonnes les plus gourmandes en mémoire. Tabular Editor vous permet d'exécuter des scripts Best Practice Analyzer pour automatiser le nettoyage des colonnes et mesures inutilisées dans l'ensemble de votre modèle.
Quel est l'effet de la cardinalité sur les performances de mes rapports ?
La cardinalité désigne le nombre de valeurs uniques d'une colonne, et une cardinalité élevée est la principale cause d'alourdissement des modèles. Les colonnes comportant de nombreuses valeurs uniques, comme des GUID ou des horodatages de haute précision, se compressent mal et ralentissent le moteur de stockage. Réduire la cardinalité en arrondissant les valeurs ou en supprimant les colonnes superflues reste le moyen le plus efficace d'alléger votre modèle et d'accélérer les requêtes.